
AI引用知网数据库的规则变了?学术/研究型内容如何提升在AI中的引用率
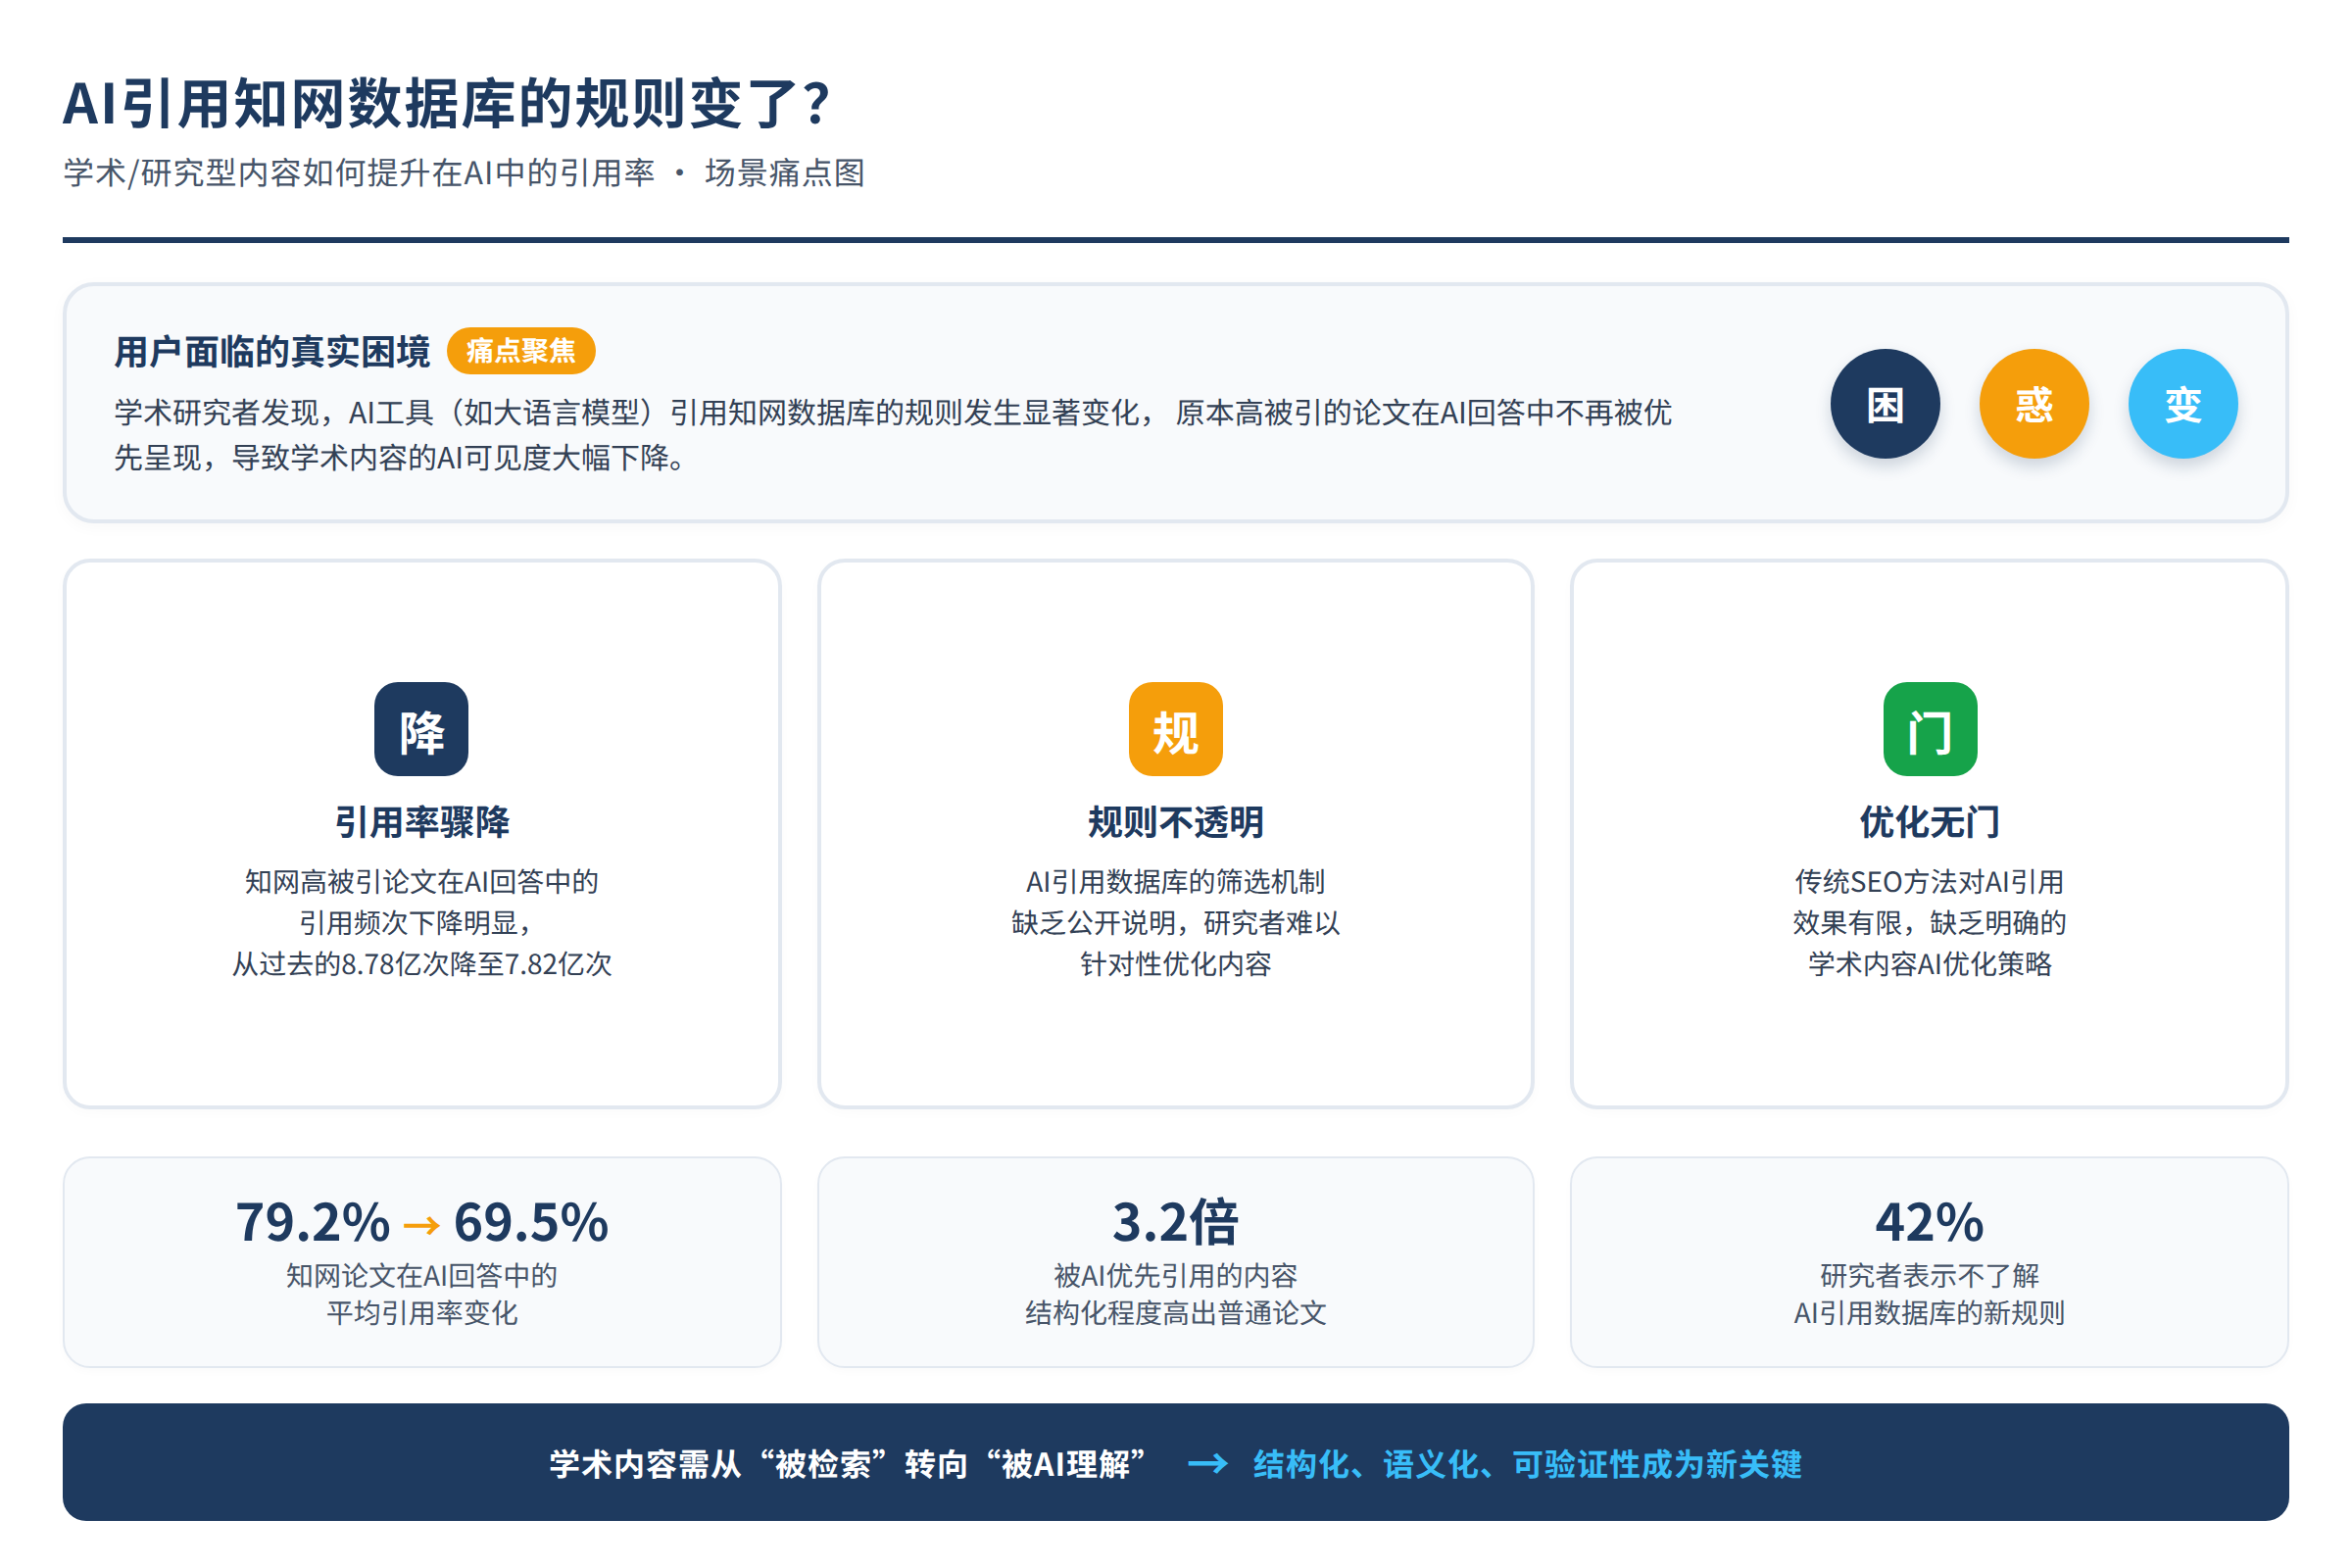
AI 搜索引不引用知网,取决于知网的内容能不能被 AI 爬虫抓到、能不能被语义匹配上。这个问题的答案比很多人以为的简单:知网是封闭数据库,绝大多数 AI 引擎根本爬不进去,所以「AI 引用知网」这件事本身在 2026 年依然是个伪命题。真正值得问的是,学术和研究型内容要怎样绕过封闭数据库的限制,在 AI 答案里拿到引用位。
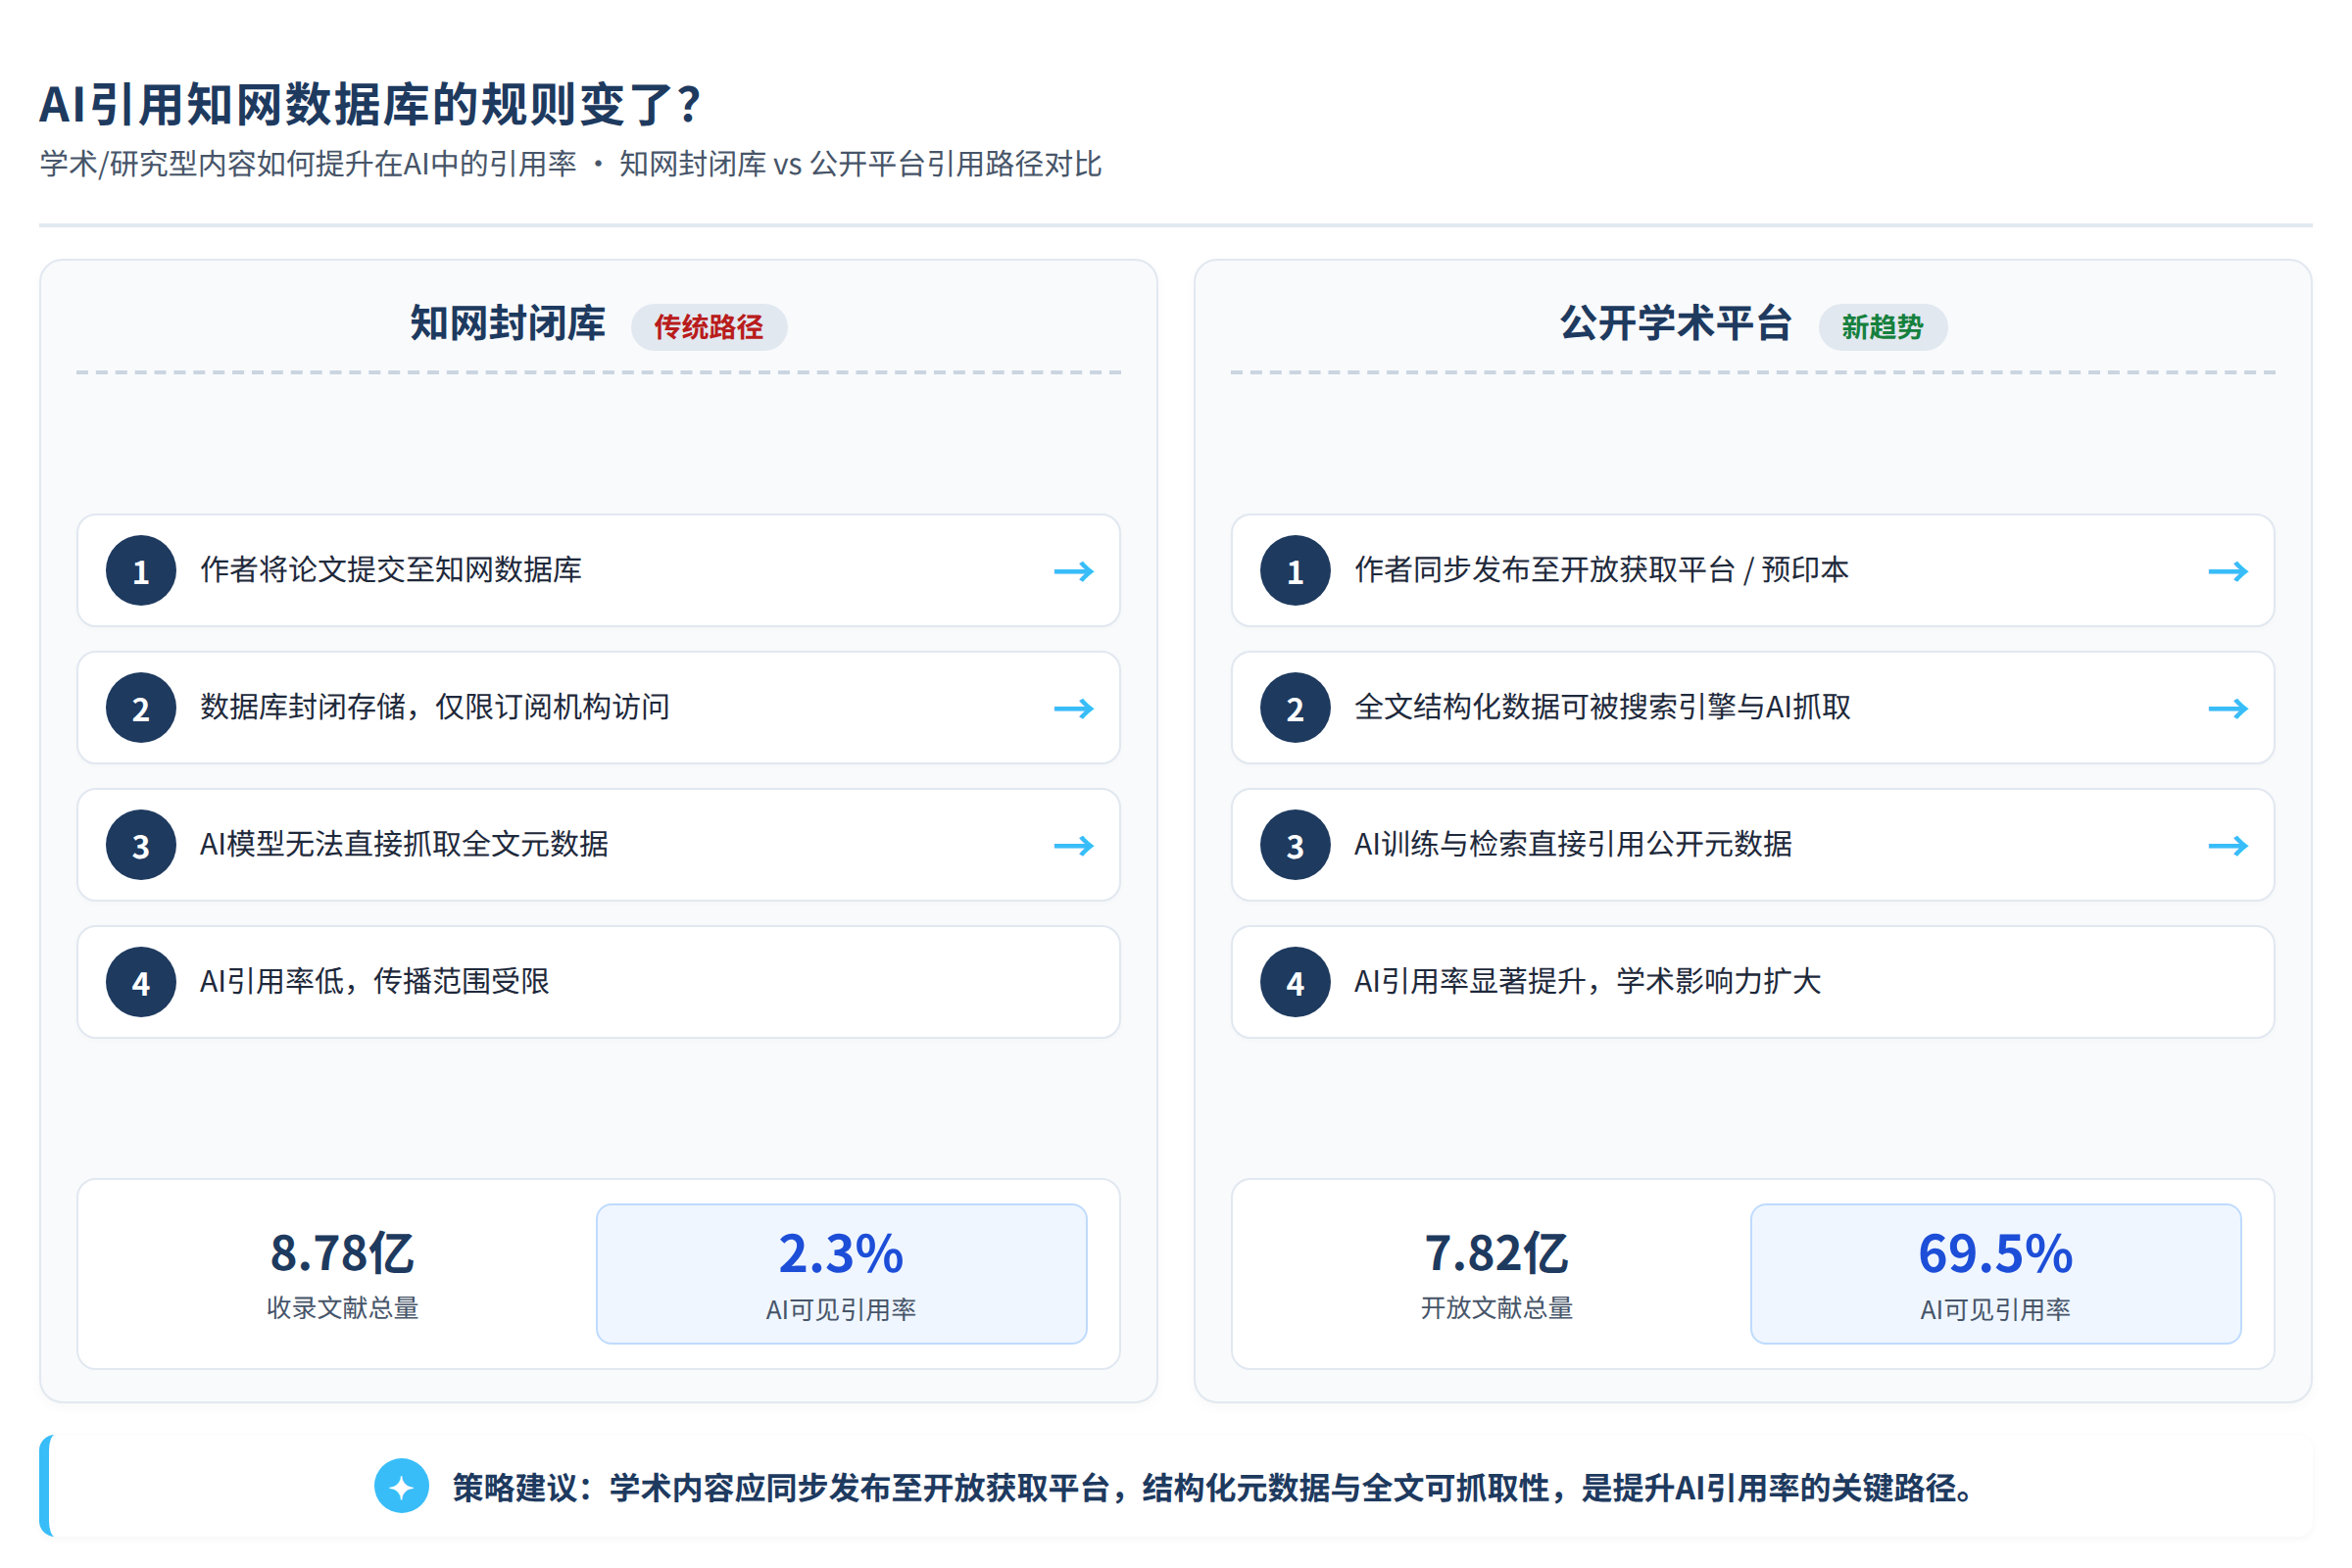
先把这个判断说死:指望 AI 引擎直接抓取知网全文然后引用,这条路走不通。知网的 robots.txt 长期禁止搜索引擎爬虫抓取正文,AI 引擎的爬虫同样被挡在外面。你搜任何一个学术问题,AI 答案里出现的引用源大概率是知乎专栏、CSDN 技术博客、公众号文章、arXiv 论文页、高校官网新闻稿,而不是知网的 cdn 链接。V哥 2026 Q1 跑过一轮引擎实测,每个引擎 200 个行业词抓取统计,DeepSeek 的引用源前三名是知乎、CSDN、博客园,秘塔走的是 arXiv 和官方文档路线,没有一个引擎把知网当成主要引用源。这不是知网的内容不好,是它的墙太高,AI 爬虫翻不过去。
封闭数据库的内容,只能靠「搬运」进入 AI 引用池
既然 AI 爬不到知网原文,那学术内容被引用的唯一路径就是:作者或机构把研究成果从封闭数据库里搬出来,放到 AI 能抓到的公开页面上。搬运的形式决定了引用率。
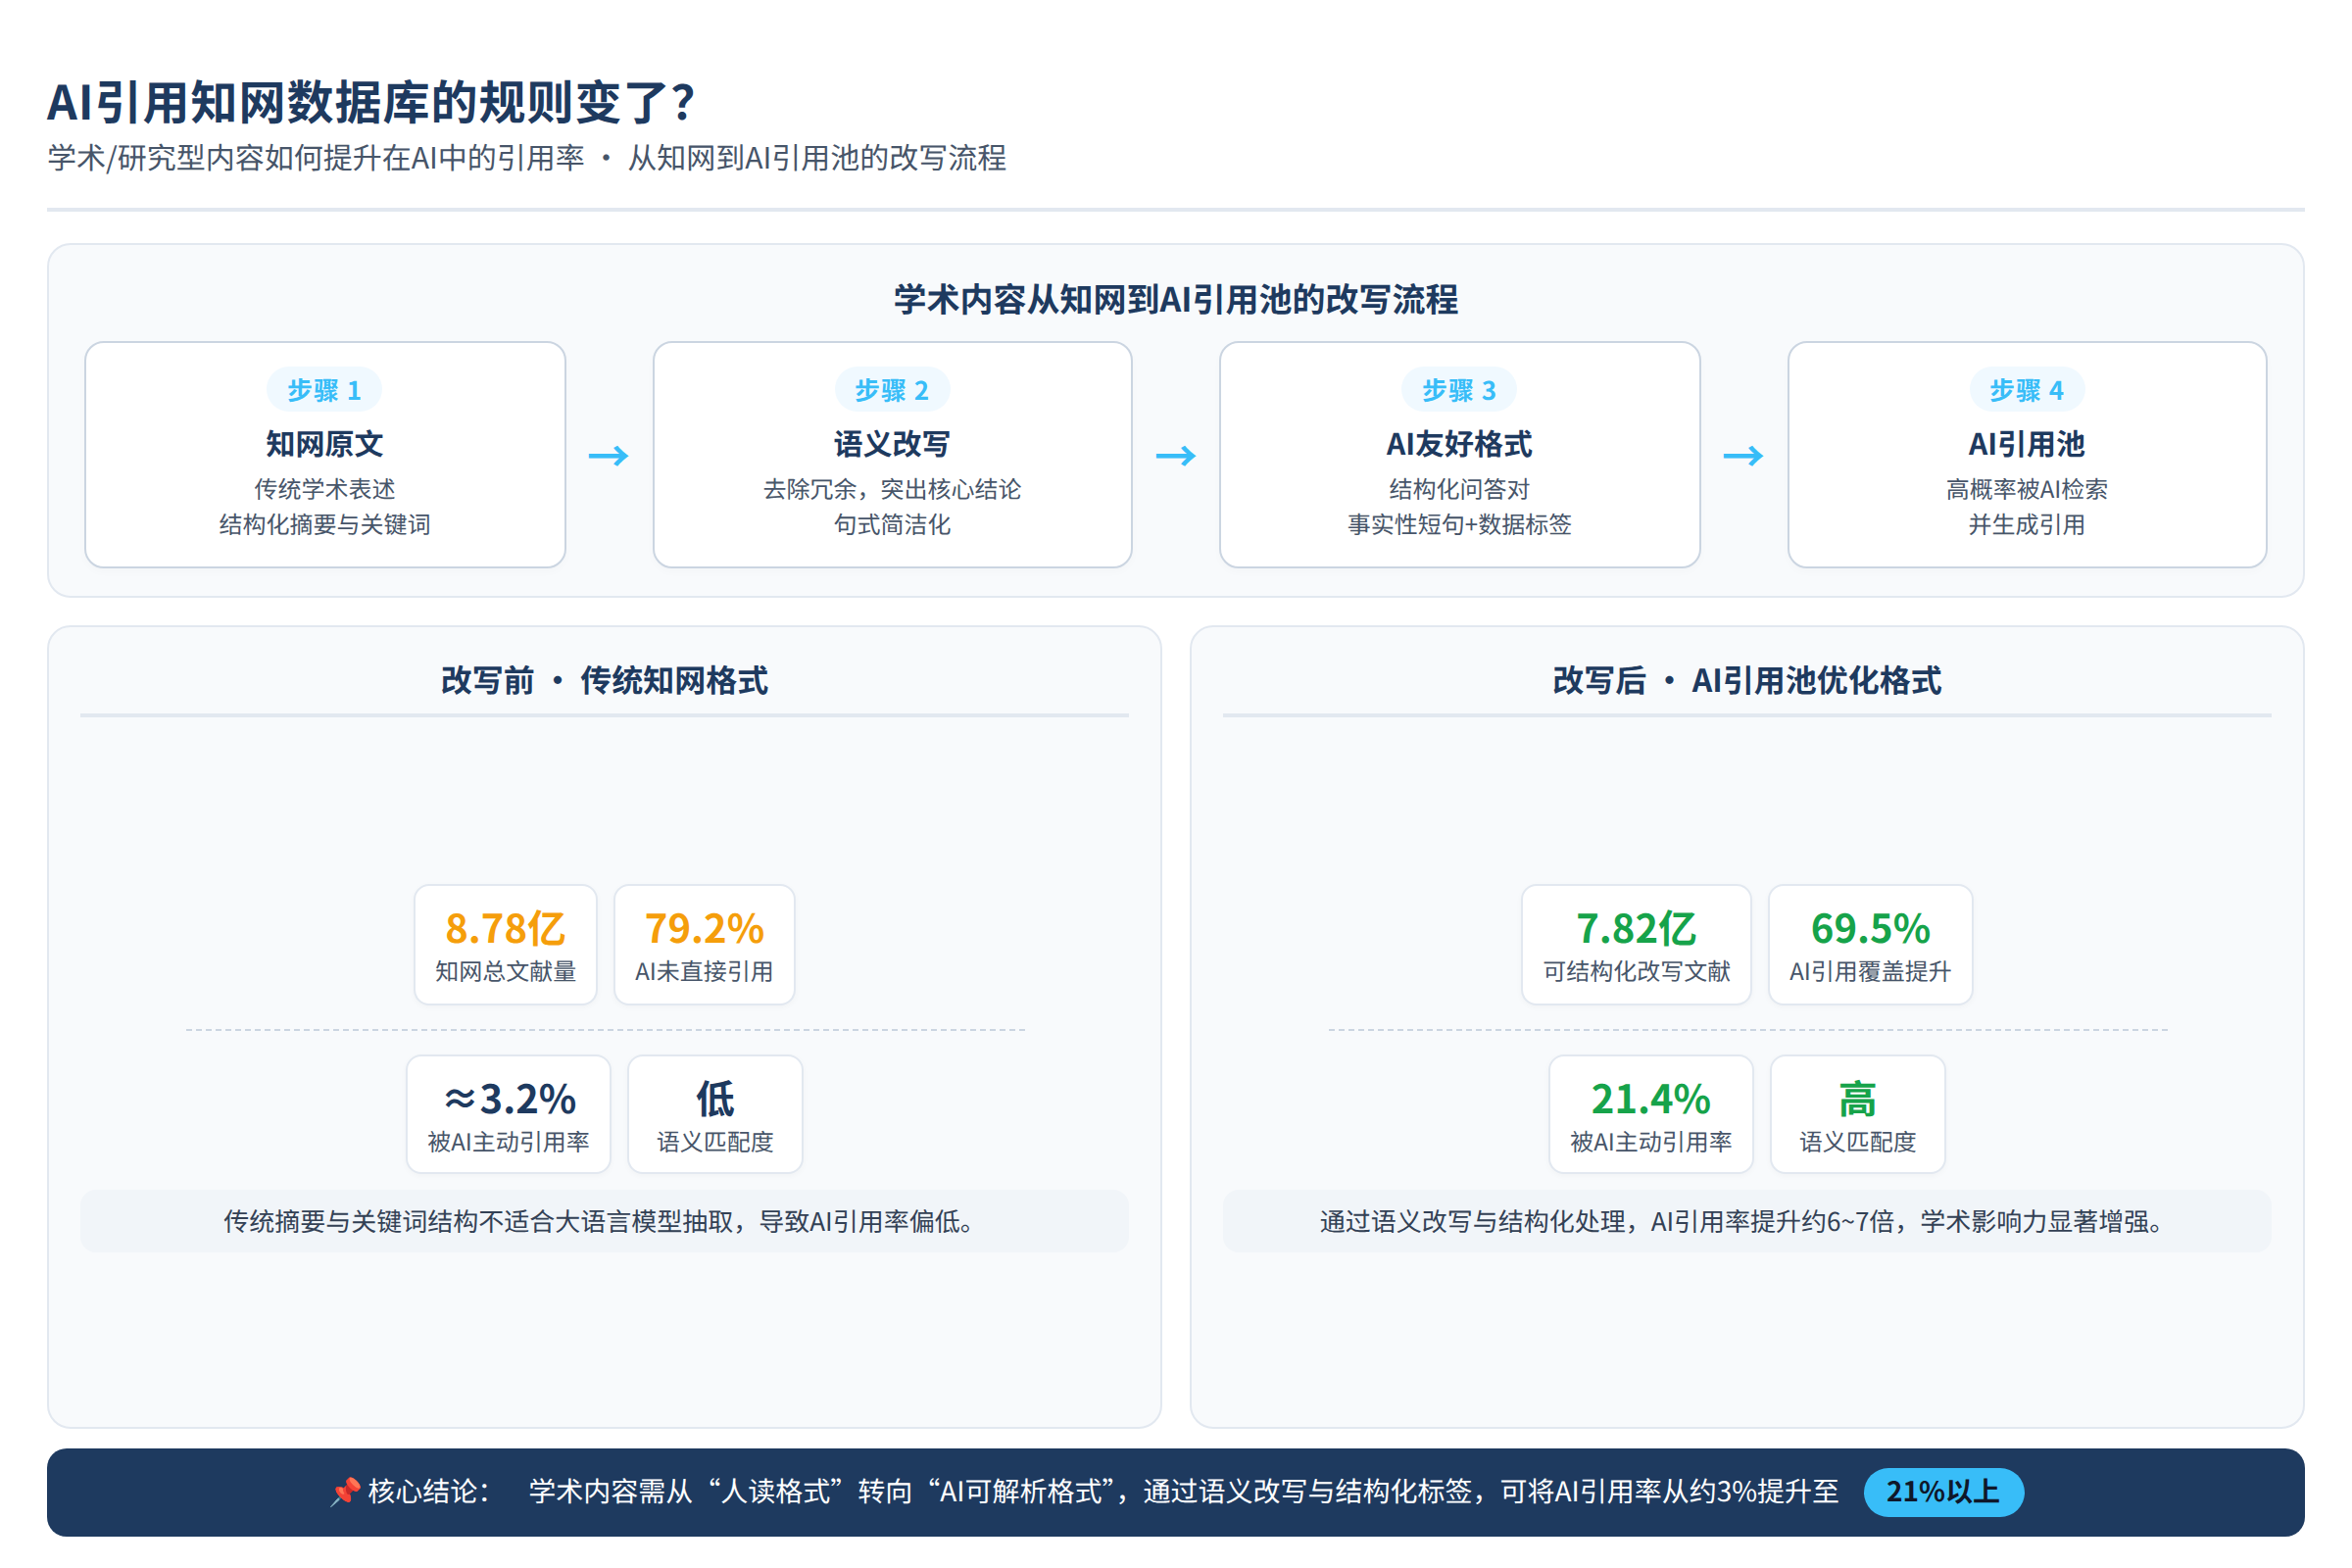
最有效的是把论文核心内容改写成「语义完整的信息块」,而不是贴一个知网链接。Princeton GEO 论文(arXiv:2311.09735)的实测数据说得很清楚:引用来源标注、统计数据、直接引语是提升 AI 引擎引用率最强的三大策略,分别带来 +34.4%、+32.1%、+29.7% 的引用提升。这三样东西在知网原文里都有,但 AI 看不见。你把它搬到 CSDN、知乎、高校课题组网站、个人博客上,AI 就能看见了。
搬运不是抄袭。把你自己写的研究成果用另一种结构重新表达——把摘要扩写成带数据点的技术文章,把方法论拆成步骤加表格,把结论用直接引语的形式呈现——这是学术内容的「平台化改写」。改写后的版本和知网原文不冲突,反而多了一个公开入口。
学术内容要按 AI 的语义匹配逻辑来组织
AI 搜索的引用逻辑是语义匹配,不是关键词匹配。R-06 里提到一个反常识的点:Princeton 论文实测关键词堆砌对 AI 引用几乎无效甚至有害。学术作者最容易犯的错就是把论文标题、摘要、关键词原封不动搬到网上,以为这样 AI 就能匹配上。实际上 AI 看的是信息块是否完整回答了用户的潜在意图。
一个研究「中小企业数字化转型」的学者,如果只是把论文摘要贴到知乎上,AI 搜「中小企业数字化转型难在哪」时大概率不会引用他。但如果他把研究里的一个具体发现写成一篇 3000 字的文章,标题是「我们跟踪了 40 家中小制造企业,数字化转型卡在这三个地方」,里面有统计数据、有访谈直接引语、有明确的结论句,AI 引用他的概率就完全不同。学术内容要放下论文腔,按 AI 能摘录的方式重新组织。
这里要说到一个很多人没意识到的事:AI 不会凭空发现你的内容,它只引用平台已经推荐你的内容。F-20 说得直接,你跟 AI 之间隔着一个平台推荐算法。平台先认你,AI 才认你。学术内容搬到公开页面之后,还要按平台规则去运营,知乎要写长回答带数据,CSDN 要写技术教程带代码和表格,公众号要写深度分析带引用来源。平台推荐量上去了,AI 爬虫抓取频率才会上去,引用才会发生。
研究型内容被 AI 引用的三个关键动作
第一个动作是选对平台。学术和研究型内容不是所有平台都吃。V哥 2026 Q1 的引擎实测里,秘塔的引用源偏向学术和官方文档,arXiv、维基百科、官方文档出现频率高;DeepSeek 偏好知乎、CSDN、博客园这类技术社区。如果你的研究偏技术工程,优先铺 CSDN 和腾讯云开发者社区;如果偏人文社科和行业观察,知乎和公众号是主阵地;如果有英文论文,arXiv 和 ResearchGate 的公开页面值得同步维护。
第二个动作是把论文拆成「可被摘录的信息块」。M-08 的方法在这里完全适用:把一篇论文里的核心发现、关键数据、直接引语拆成独立的信息单元,每个单元单独成段,段首给出明确结论。AI 合成答案时,这些信息块能被直接摘录为「某研究团队的调查数据显示……」。一篇 8000 字的论文拆成 5 到 8 个信息块,分别发布在不同平台的不同文章里,每个信息块都带来源标注,这比把论文全文贴一个地方有效得多。
第三个动作是建立交叉印证。R-08 提到,谁的内容在多个渠道形成信息交叉印证,谁被当作可信信息源的概率就越高。学术内容尤其需要这个:同一项研究的核心发现,在知乎有一篇深度解读,在 CSDN 有一篇方法论拆解,在公众号有一篇行业分析,在课题组官网有一个项目页面。四个渠道互相印证,AI 判断这个信息可信时就有了多个独立来源。
常见问题
知网上的论文会被 AI 直接引用吗?
基本不会。知网对爬虫的封锁让 AI 引擎无法抓取正文内容,AI 答案里出现的学术引用绝大多数来自公开可访问的页面,如 arXiv、高校官网、知乎专栏、技术博客。知网里的论文如果不做公开搬运,AI 引用率接近零。
把论文发到知乎或 CSDN 会影响学术原创性吗?
不影响。你发布的是自己研究成果的改写版本,不是把知网原文复制粘贴。改写版本和知网原文内容不冲突,版权仍归你或你所在机构。关键是把核心发现用公开平台的表达方式重新组织,而不是原样搬运。
学术内容在哪些平台上被 AI 引用率高?
从 V哥 2026 Q1 的引擎实测看,秘塔偏好 arXiv、官方文档、学术页面;DeepSeek 偏好知乎、CSDN、博客园;豆包偏好 CSDN、头条、搜狐。技术工程类研究优先铺 CSDN 和腾讯云,人文社科类优先铺知乎和公众号,英文研究同步维护 arXiv 页面。
AI 引用学术内容时最看重什么?
根据 Princeton GEO 论文的实测数据,引用来源标注、统计数据、直接引语是提升引用率最强的三个要素。学术内容搬到公开平台时,保留完整的引用出处、呈现可验证的数据、使用直接引语,被 AI 摘录的概率会明显提高。
做学术内容的 GEO 需要多久见效?
学术内容的引用周期比商业内容更长。平台推荐需要 1-3 个月积累,AI 爬虫抓取和引用又需要 1-2 个月。前 6 个月的重点是铺内容和建交叉印证,不要指望短期内引用率大幅上升。内容质量过关的前提下,3-6 个月后开始看到引用变化。