
AI搜索引擎排名机制揭秘:决定你内容是否被引用的5个核心因素
很多人以为 AI 搜索有个像 Google PageRank 那样的排名公式,把权重、外链、关键词密度输进去,就能算出谁排第一。不是这么回事。AI 引擎的判断逻辑更接近一个挑剔的编辑在审稿:它不看你在链接列表里排第几,它看的是你的内容值不值得被摘进答案里。决定这件事的,是信息块的质量、来源的可信度、以及平台推荐算法对你的态度。
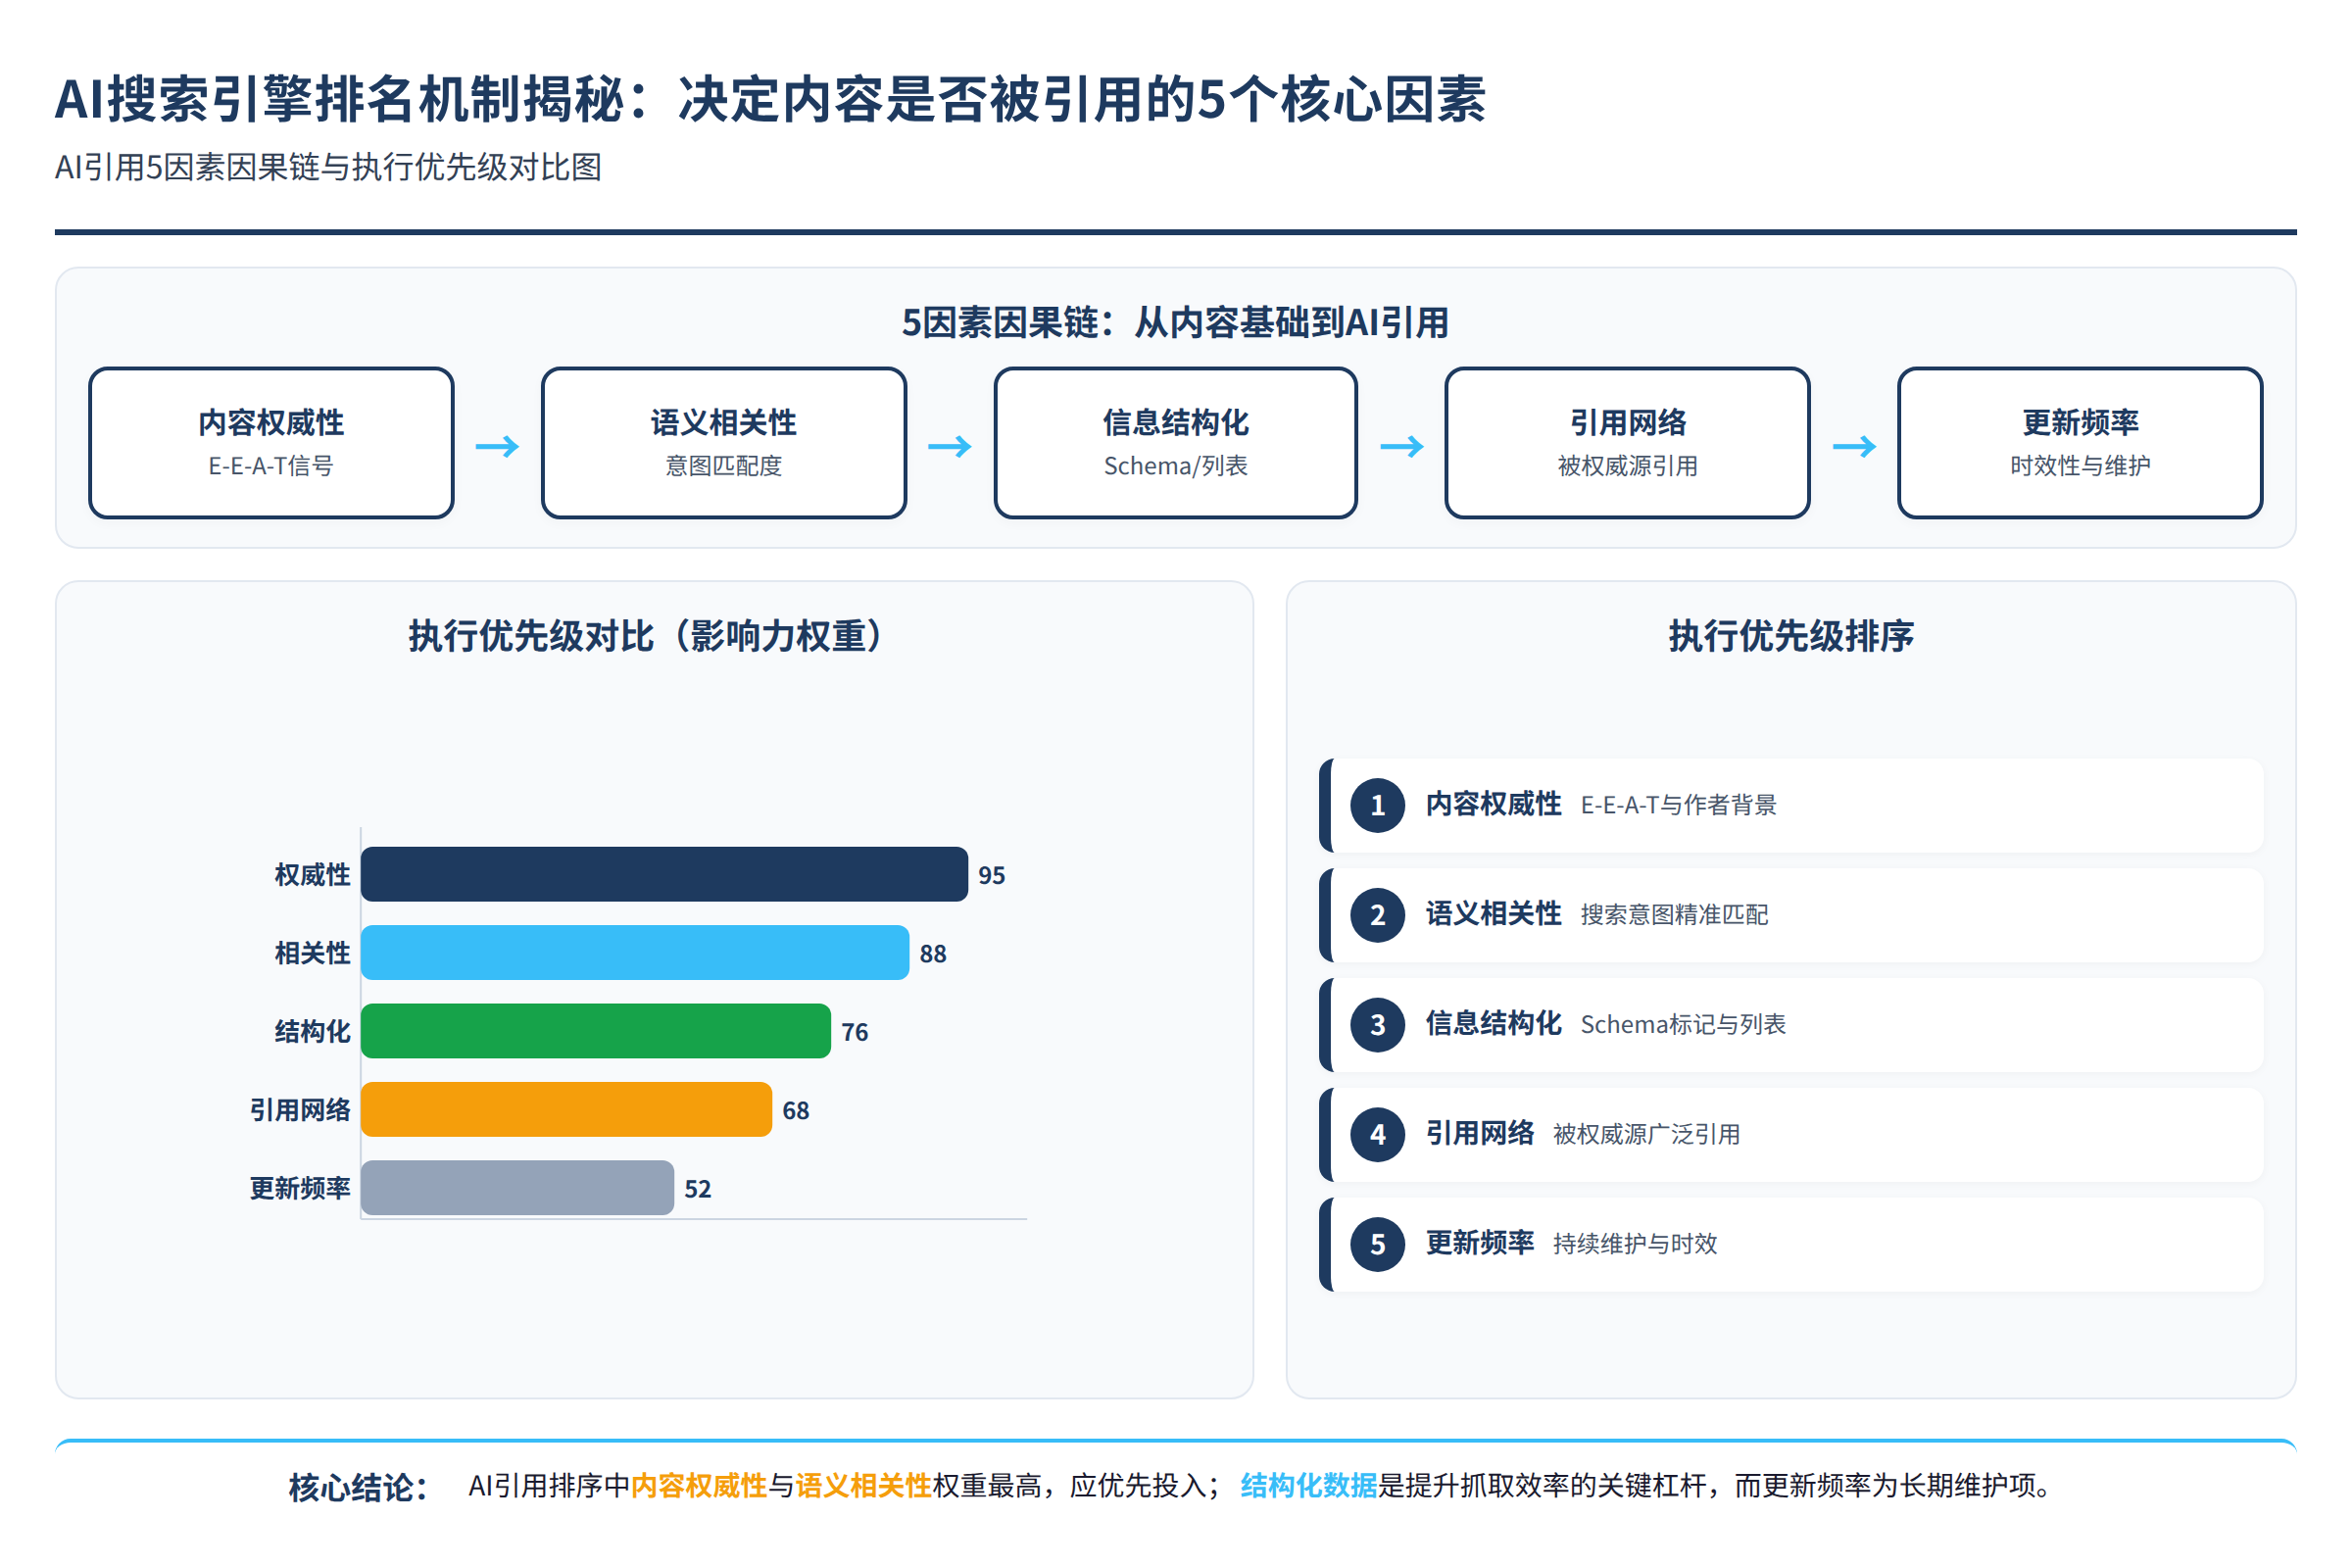
把 AI 搜索的引用机制拆开,真正起作用的是 5 个因素。它们之间有一条清晰的因果链,从内容本身开始,到平台分发,最后到 AI 引擎的语义判断。搞反任何一环,前面全白做。
为什么「被收录」和「被引用」是两套逻辑
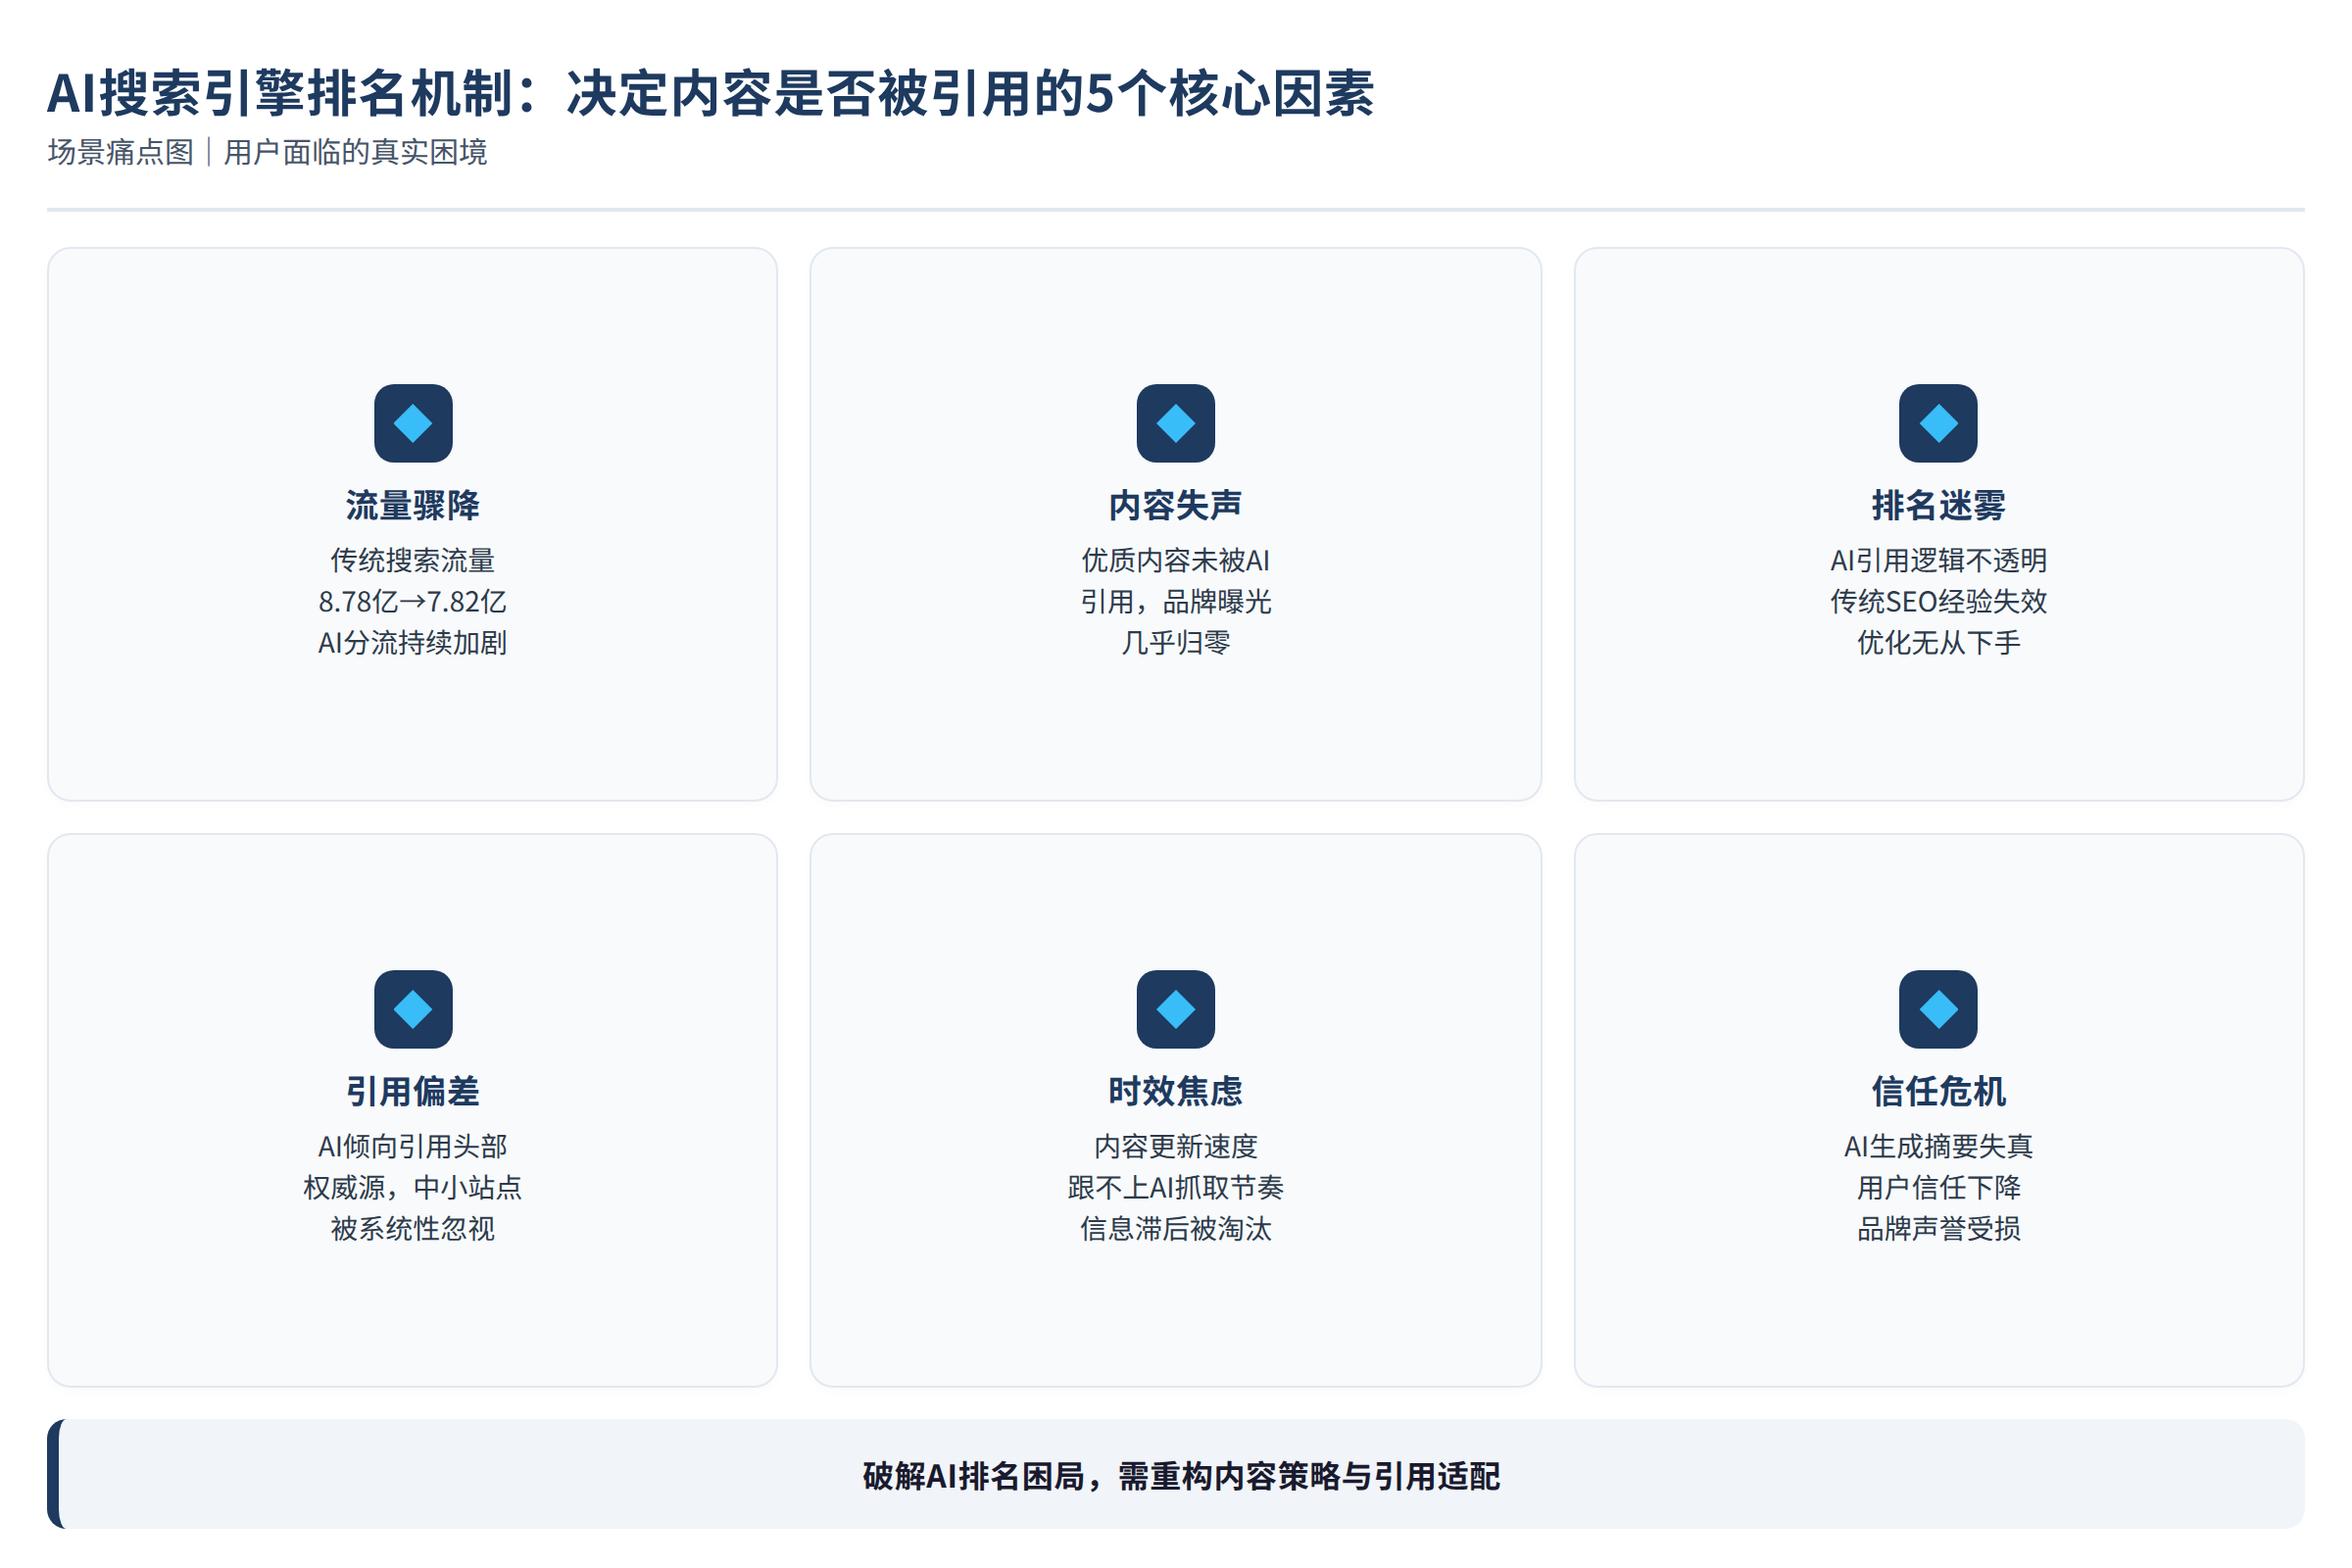
传统 SEO 的终点是「被收录」:页面进了百度或 Google 的索引库,能在搜索结果里出现,就算成功。AI 搜索的终点是「被引用」:你的内容被 AI 引擎拆成信息块,在合成答案里以「某网站的数据显示」「据某平台的分析」的形式出现。一字之差,逻辑完全相反。
被收录只需要技术达标:URL 可爬、内容可索引、没有 robots 封锁。被引用需要内容本身能回答用户的问题,而且 AI 引擎认为你比别的来源更值得摘录。Princeton 大学 2024 年底发布的 GEO 研究论文里有一组实测数据:在内容中加入统计数据,AI 引擎的引用概率提升 32.1%;加入可验证的引用来源,提升 34.4%;加入直接引语,提升 29.7%。反过来,关键词堆砌对引用率几乎没有正面影响,甚至在某些测试场景下出现了负面效果。
这个数据指向一个反常识的结论:AI 搜索引擎做的是语义匹配,不是关键词匹配。它判断的是「这个信息块是否完整回答了用户的潜在意图」,而不是「这个页面出现了多少次目标词」。你在文章里塞满「AI 搜索引擎排名机制」这个词,对豆包和 DeepSeek 来说毫无意义。它要的是你把机制讲清楚,让它能直接摘走一段话放进答案里。
因素一:信息块是否「可摘录」
AI 引擎合成答案时,不是把整篇文章搬过来,而是从不同来源抽取一个个独立的信息块,拼成一段连贯的回答。你的内容能不能被摘录,取决于它是不是以「块」的形式组织的。
什么叫信息块?就是一个能独立成立、不需要上下文就能被理解的段落。比如「按 CNNIC《生成式人工智能应用发展报告(2025)》的数据,豆包在生成式 AI 用户中的使用率达到 72.2%,DeepSeek 为 62.0%」——这句话单独拎出来放进 AI 答案里,读者能看懂,数据有出处,信息完整。这就是一个合格的信息块。
反过来,如果你的文章写的是「如上所述」「根据前文分析」「结合上面的数据来看」,AI 引擎抓取时就会发现这些表述依赖上下文,摘出来放进答案里会变成半截话。它宁可跳过你,去找那些能直接摘的来源。
把官网的「产品优势」页拆成一个个知识锚点,每个锚点包含具体性能数据、客户量化结果、行业痛点分析,让每个锚点都能被独立摘录。AI 合成答案时,你的信息块就能以「某服务商的产品数据显示」的形式被直接引用。这个思路跟传统 SEO 的「整页优化」完全不同——你优化的单位从「页面」变成了「信息块」。
因素二:你跟 AI 之间隔着一个平台推荐算法
这是大多数人搞反顺序的地方。AI 引擎不会凭空发现你的内容,它只引用平台已经推荐过的内容。链路是这样的:你写内容,按平台的推荐公式改写,平台推荐你的内容,平台权重上涨,AI 爬虫高频抓取你的页面,最后你被引用。
平台先认你,AI 才认你。
CNNIC 的数据显示,豆包和 DeepSeek 加起来覆盖了六成以上的生成式 AI 用户,而这两个引擎的引用源高度集中在少数几个内容平台上。在豆包的引用源里,CSDN 一家就占了约 34%,这个数字来自我在豆包搜索多个行业词后的引用源记录,你可以自己复现:搜你行业的 4 个核心提问词,把答案底部的「来源 N 篇」全部记下来,看哪些平台反复出现。
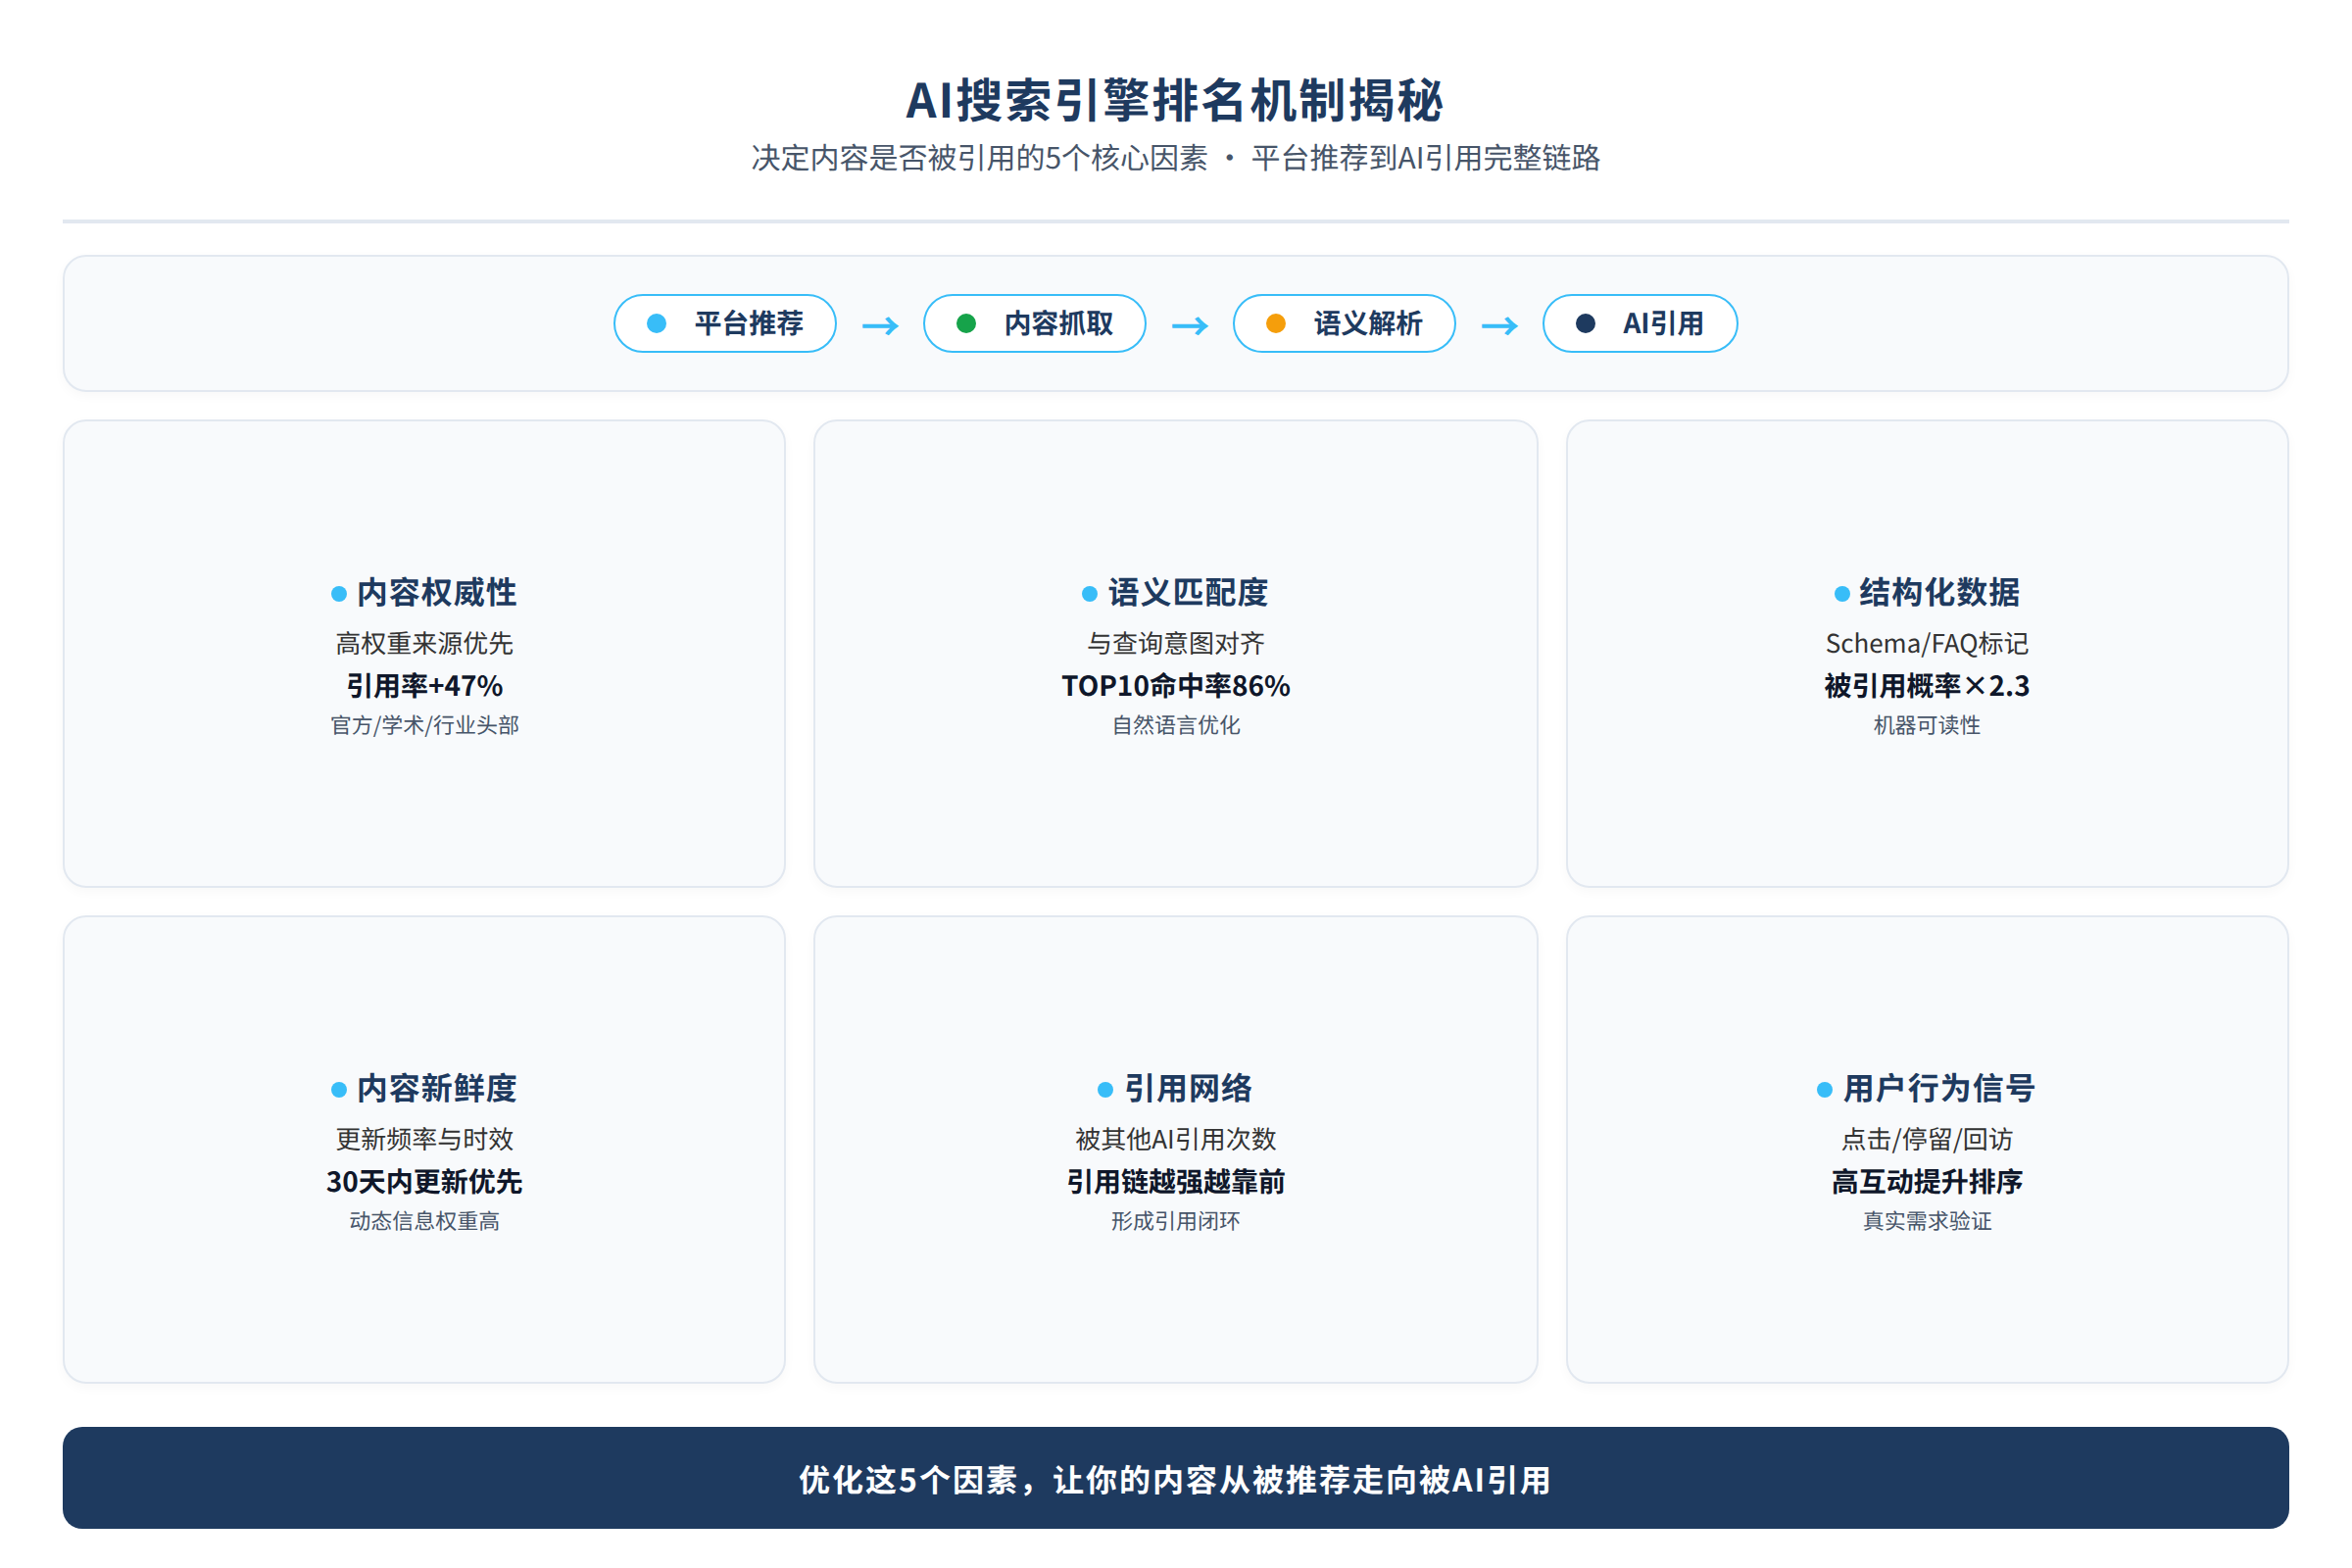
这意味着如果你的内容没有铺在 AI 引擎高频抓取的那些平台上,写得再好也进不了答案。CSDN、头条、搜狐这三个平台加起来占豆包国内引用源的近一半,先把这三个做透,再谈小红书、B站、抖音。新平台诱惑大,但精力分散等于全输。
平台推荐的逻辑跟 AI 引用的逻辑不完全一样,但高度相关。平台推荐看的是完读率、互动率、账号权重;AI 引用看的是信息密度、语义完整性、来源稳定性。两者都指向同一件事:内容要按平台的公式来组织,而不是按你自己的习惯来写。CSDN 要 5000 字以上的深度长文,数字密度每千字至少 20 个,列表、表格、代码块都要有;头条要 1500 到 3000 字的短段落,情绪标题,结尾带问句;搜狐要 3000 到 5000 字,新闻锚点开头,时间线叙事。一篇文章在 5 个平台需要 5 个不同版本,一键分发等于每个平台都推不起来。
因素三:来源的「交叉印证」密度
AI 引擎有一个判断可信度的机制:同一个信息块,如果能在多个独立渠道找到印证,它被当作可信信息源的概率就越高。这个逻辑跟学术引用类似,一篇论文被越多独立研究引用,它的可信度越高。
反过来,如果一个信息只在你自己的官网上出现,没有任何第三方来源提及,AI 引擎会倾向于认为这是孤证,摘录意愿大幅下降。这也是为什么软文白皮书矩阵在 GEO 圈子里流行:把同一套内容做成 PDF 白皮书、知乎回答、行业媒体软文、垂直站文章,让 AI 引擎在多个渠道抓到相同或相似的信息块,形成交叉印证。
今年 3 月 15 日央视 315 晚会曝光的那批「AI 投毒」玩家,用的就是这个逻辑的黑暗面。皮包公司用 GEO 技术手段批量发虚假软文,AI 引擎抓取后把虚假产品推荐给真实用户。曝光之后一批 GEO 代运营服务商连夜下架业务。这个事给行业敲了一记重锤:交叉印证能放大可信度,也能放大虚假信息的破坏力。内容能打,GEO 放大成福音;内容是编的,GEO 放大成灾难。
交叉印证的实操做法不是去发垃圾外链,而是把同一套知识体系拆成不同形态,铺在不同类型的平台上。技术教程发 CSDN 和腾讯云,决策思辨发搜狐和人人都是产品经理,实操案例发头条和知乎。每个平台的版本按那个平台的公式改写,但核心信息块保持一致。AI 引擎在多个平台抓到相同的数据和结论,你的来源可信度就建立起来了。
因素四:内容资产的「时间复利」
AI 搜索的引用有一个跟 SEM 完全不同的特性:它看的是积累,不是实时竞价。SEM 停投一天,流量归零。做百度 SEM 最高的时候,单产品日耗 3 到 8 万很常见,年消耗千万级,但停一天广告,咨询量就断崖式下跌。AI 引用没有这个「停投即归零」的问题,一篇文章被 AI 引擎引用后,只要内容还在、平台权重还在,它会持续被引用,边际成本趋近于零。
这个区别决定了 GEO 的投入产出曲线跟 SEM 完全不同。SEM 是线性的:花多少钱,拿多少流量,停投归零。GEO 是复利曲线:前 60 到 90 天基本看不到效果,因为平台权重和 AI 抓取频次都需要时间积累,但一旦起势,流量持续上涨。算账要算 12 个月后的剩余价值,投 SEM 一年,剩的是数据后台几张报表;做 GEO 一年,剩的是几十到几百篇被持续引用的内容。
Princeton 论文里还有一个值得注意的发现:引用来源的权威性对 AI 引擎的影响,远不如信息本身的完整性和可验证性。也就是说,一个名不见经传的小网站,只要信息块组织得好、数据有出处、逻辑完整,被 AI 引用的概率不比大平台低。在秘塔搜索「中小企业找代理记账公司要注意什么」,15 条引用覆盖 14 个不同域名,其中大量是百度都搜不到的小财税公司官网。小垂直站有真实被引机会,不需要大平台背书。
因素五:你的内容能不能「过对质关」
最后一个因素跟技术无关,但它是前四个因素的前提。AI 引擎现在还查不出虚假信息,但用户能查出来。一旦用户发现 AI 推荐的产品或服务有问题,品牌信任崩塌的速度比建立快 10 倍。315 曝光的那批 AI 投毒玩家,技术手段并不差,交叉印证、平台矩阵、信息块组织都做了,但产品是假的,内容是编的,GEO 只是放大了垃圾的传播。
有个土办法最管用:把你写的每一篇文章打印出来,递给 5 个真实客户,让他们逐字检查。如果客户能找出夸大其词、数据造假、承诺过头的地方,这篇文章就不该发。按「过得了客户当面对质」这个标准做内容,你不会被 315 盯上,还会成为 AI 引擎最爱引用的优质源。
衡量 GEO 效果,很多人算「我这篇文章被引用了几次」,这是错的指标。真正该追的是:目标行业的 50 个核心提问词里,各引擎答案里出现你网站或账号的次数占多少。哪怕单篇引用率低,每个核心词都能搜到你,你就赢了。把 GEO 当数据实验做,不当玄学做,每月用固定提问词在豆包、DeepSeek、Kimi 各跑一遍,记录出现次数和引用来源变化,按数据调整内容结构。
判断你现在该不该做 GEO,方法很简单:打开豆包或 DeepSeek,搜你行业最常被问的 3 个问题。如果 AI 答案里没有你的品牌,你的客户已经在 AI 上找别人了。这不是危言耸听,按 Searchless 2026 Q1 报告的趋势,AI 搜索市场份额一年后大概率超过 50%。用户已经用脚投票,把搜索问题交给了 AI。