
如何生成sitemap.xml站点地图?
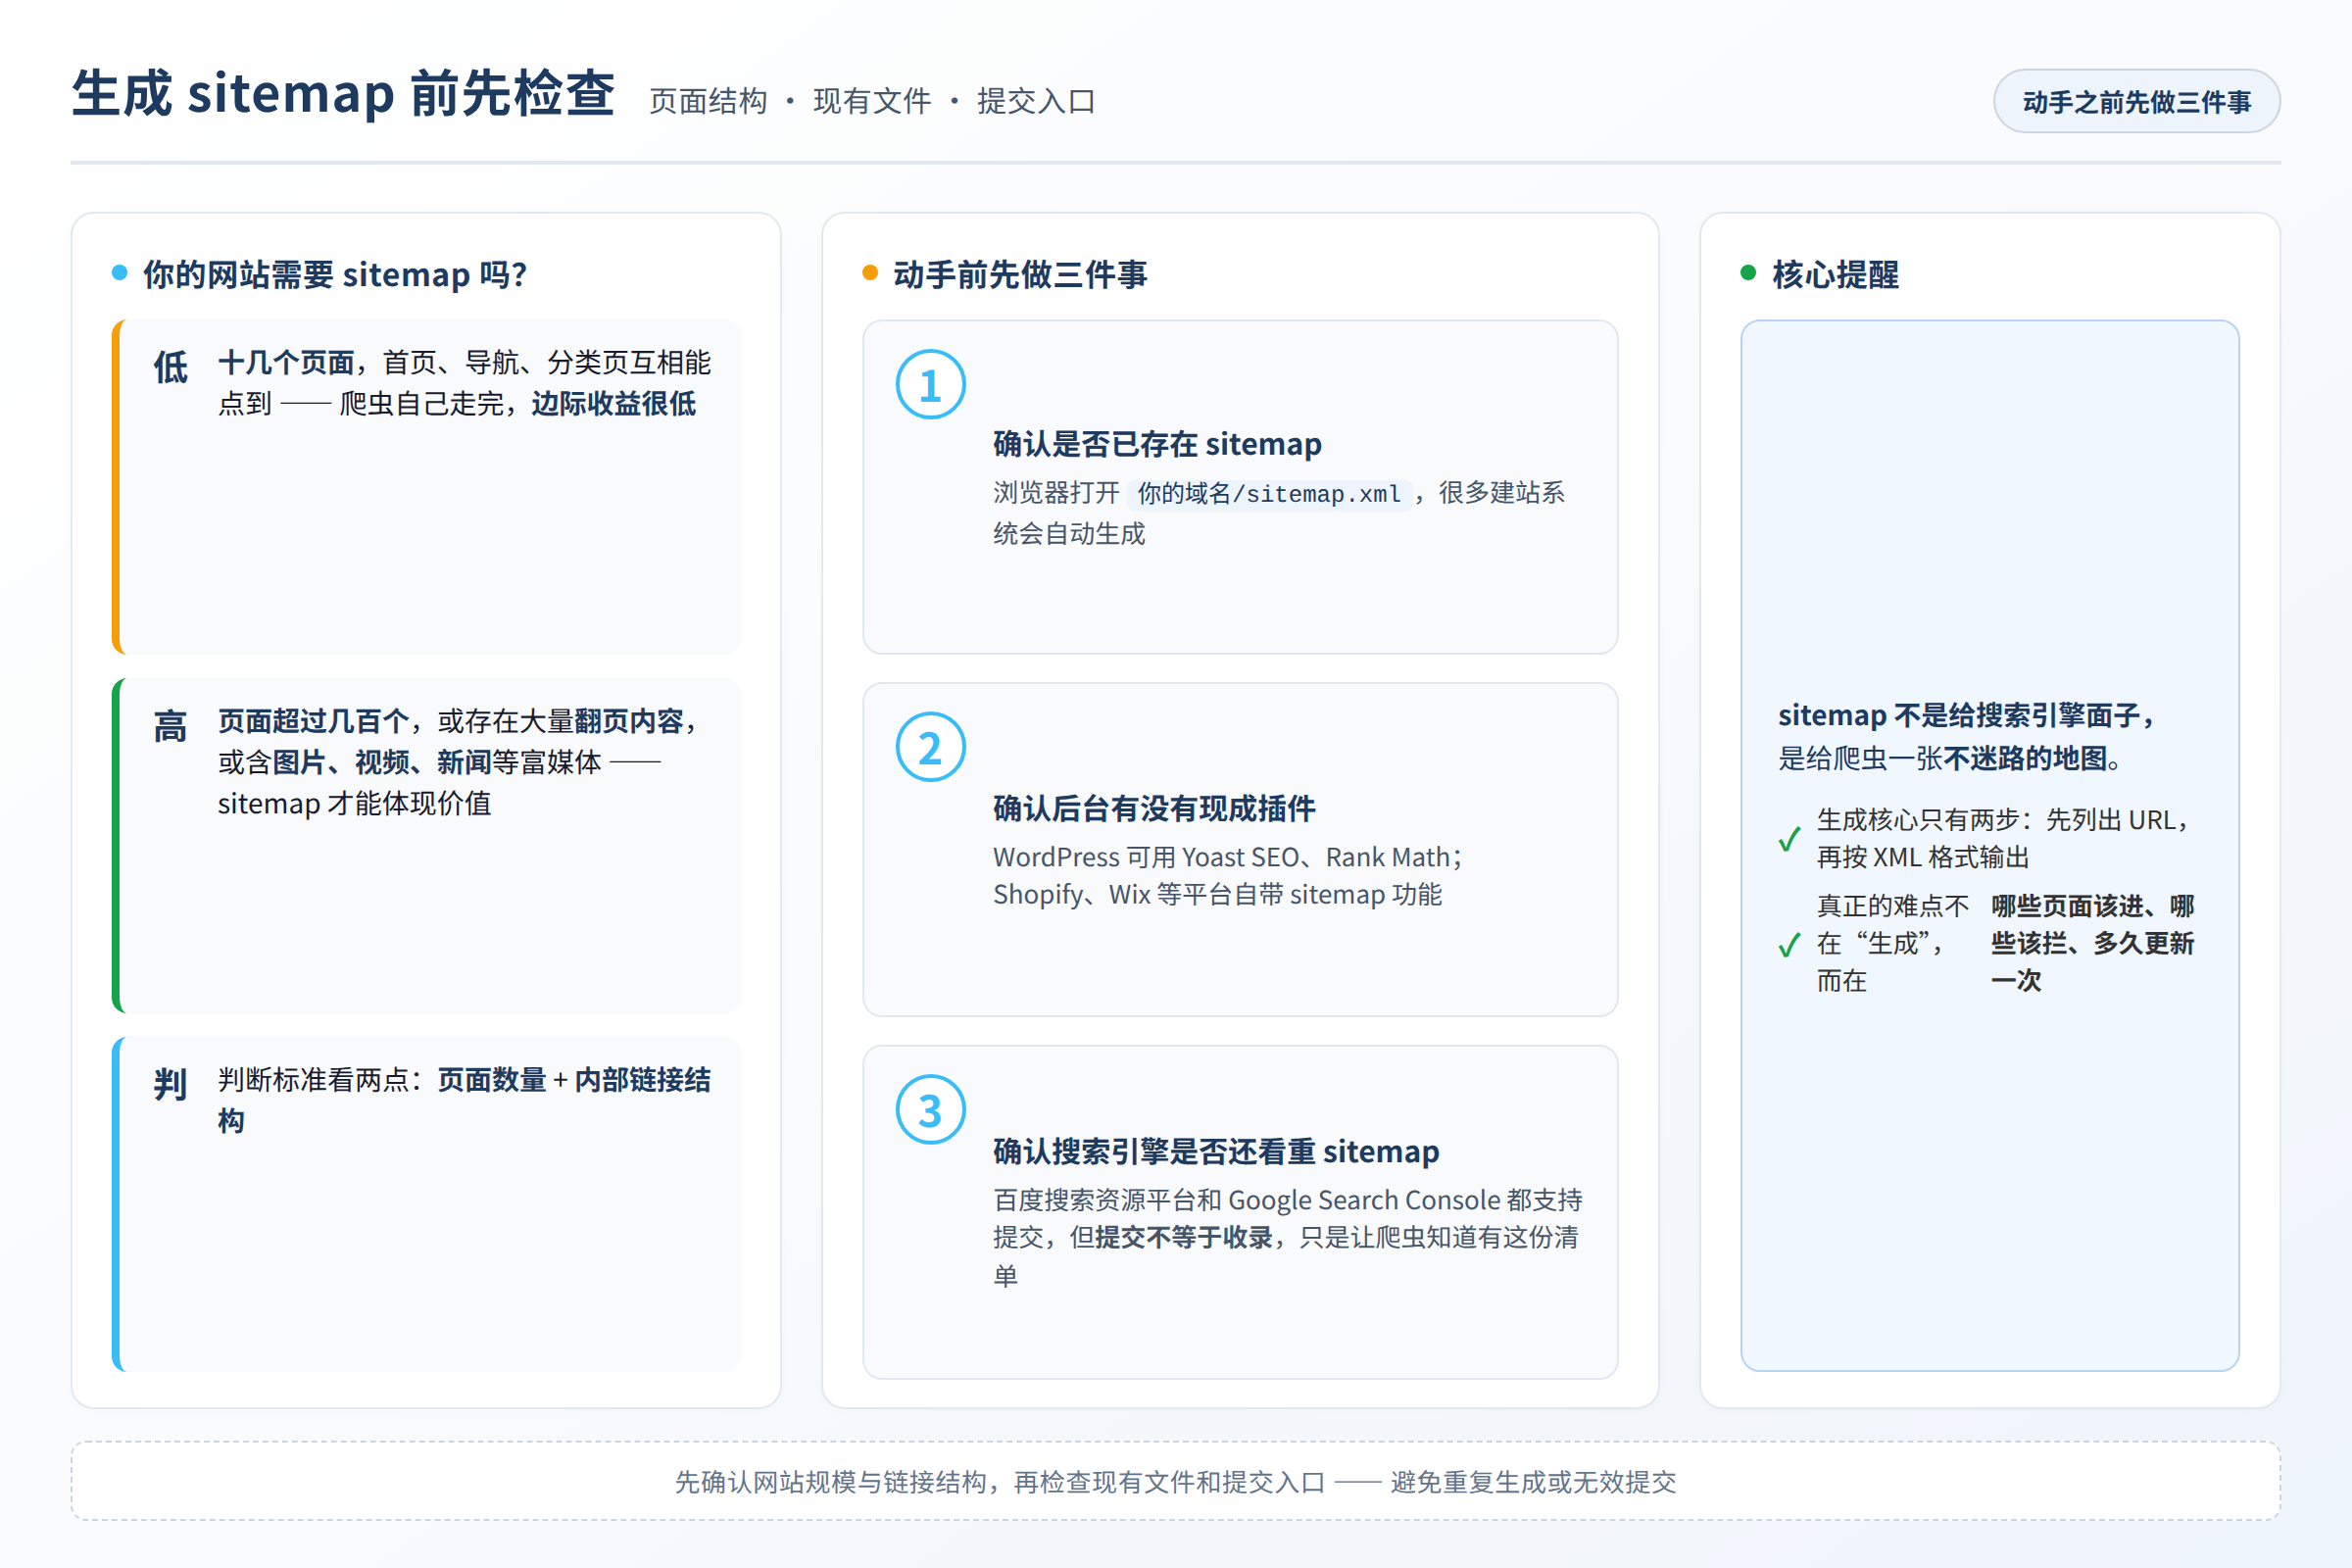
TL;DR:主题:如何生成sitemap.xml站点地图? 正文: 站点地图不是给搜索引擎面子,是给爬虫一张不迷路的地图。生成 sitemap.xml 的核心只有两步:先列出你希望被收录的 URL,再按 XML 格式输出。真正的难点不在“生成”,而在“哪些页面该进、哪些该拦、多久更新一次”。下面按可执行顺序拆开讲。
主题:如何生成sitemap.xml站点地图? 正文: 站点地图不是给搜索引擎面子,是给爬虫一张不迷路的地图。生成 sitemap.xml 的核心只有两步:先列出你希望被收录的 URL,再按 XML 格式输出。真正的难点不在“生成”,而在“哪些页面该进、哪些该拦、多久更新一次”。下面按可执行顺序拆开讲。
先确认你的网站到底需不需要 sitemap
不是每个网站都必须做 sitemap。判断标准看两点:页面数量和内部链接结构。
如果你的网站只有十几个页面,而且首页、导航、分类页之间互相能点到,搜索引擎爬虫基本能自己走完,sitemap 的边际收益很低。但如果页面超过几百个、存在大量需要翻页才能到达的内容、或者有图片、视频、新闻等富媒体内容,sitemap 才能体现价值。
动手之前先做三件事:
- 确认网站是否已经存在 sitemap。直接在浏览器打开
你的域名/sitemap.xml,很多建站系统会自动生成。 - 确认后台有没有现成插件。WordPress 可以用 Yoast SEO、Rank Math,Shopify、Wix 等平台自带 sitemap 功能。
- 确认你要提交的搜索引擎是否还看重 sitemap。百度搜索资源平台和 Google Search Console 都支持提交,但提交不等于收录,只是让爬虫知道有这份清单。
哪些 URL 该放进 sitemap
这一步比生成动作更重要。sitemap 里放什么,直接影响爬虫对你网站结构的判断。
该放的页面:
- 所有希望被用户搜索到的核心页面,包括产品页、服务页、文章详情页、分类页。
- 更新频率较高的内容页,比如博客、新闻、案例库。
- 孤立页面:只能通过站内搜索或特定入口到达、没有内链指向的页面。
不该放的页面:
- 带参数的重复页,比如同一页面带
?sort=price、?color=red的变体。 - 登录、注册、购物车、个人中心等无搜索价值页面。
- 被 robots.txt 屏蔽的页面。sitemap 里出现 robots 禁止抓取的 URL,属于自相矛盾。
- 返回 404、301、302 的 URL。sitemap 应该只放 200 状态码的页面。
一个容易忽略的细节:sitemap 中的 URL 必须是完整绝对路径,比如 https://www.example.com/products/123,不能写相对路径 /products/123。
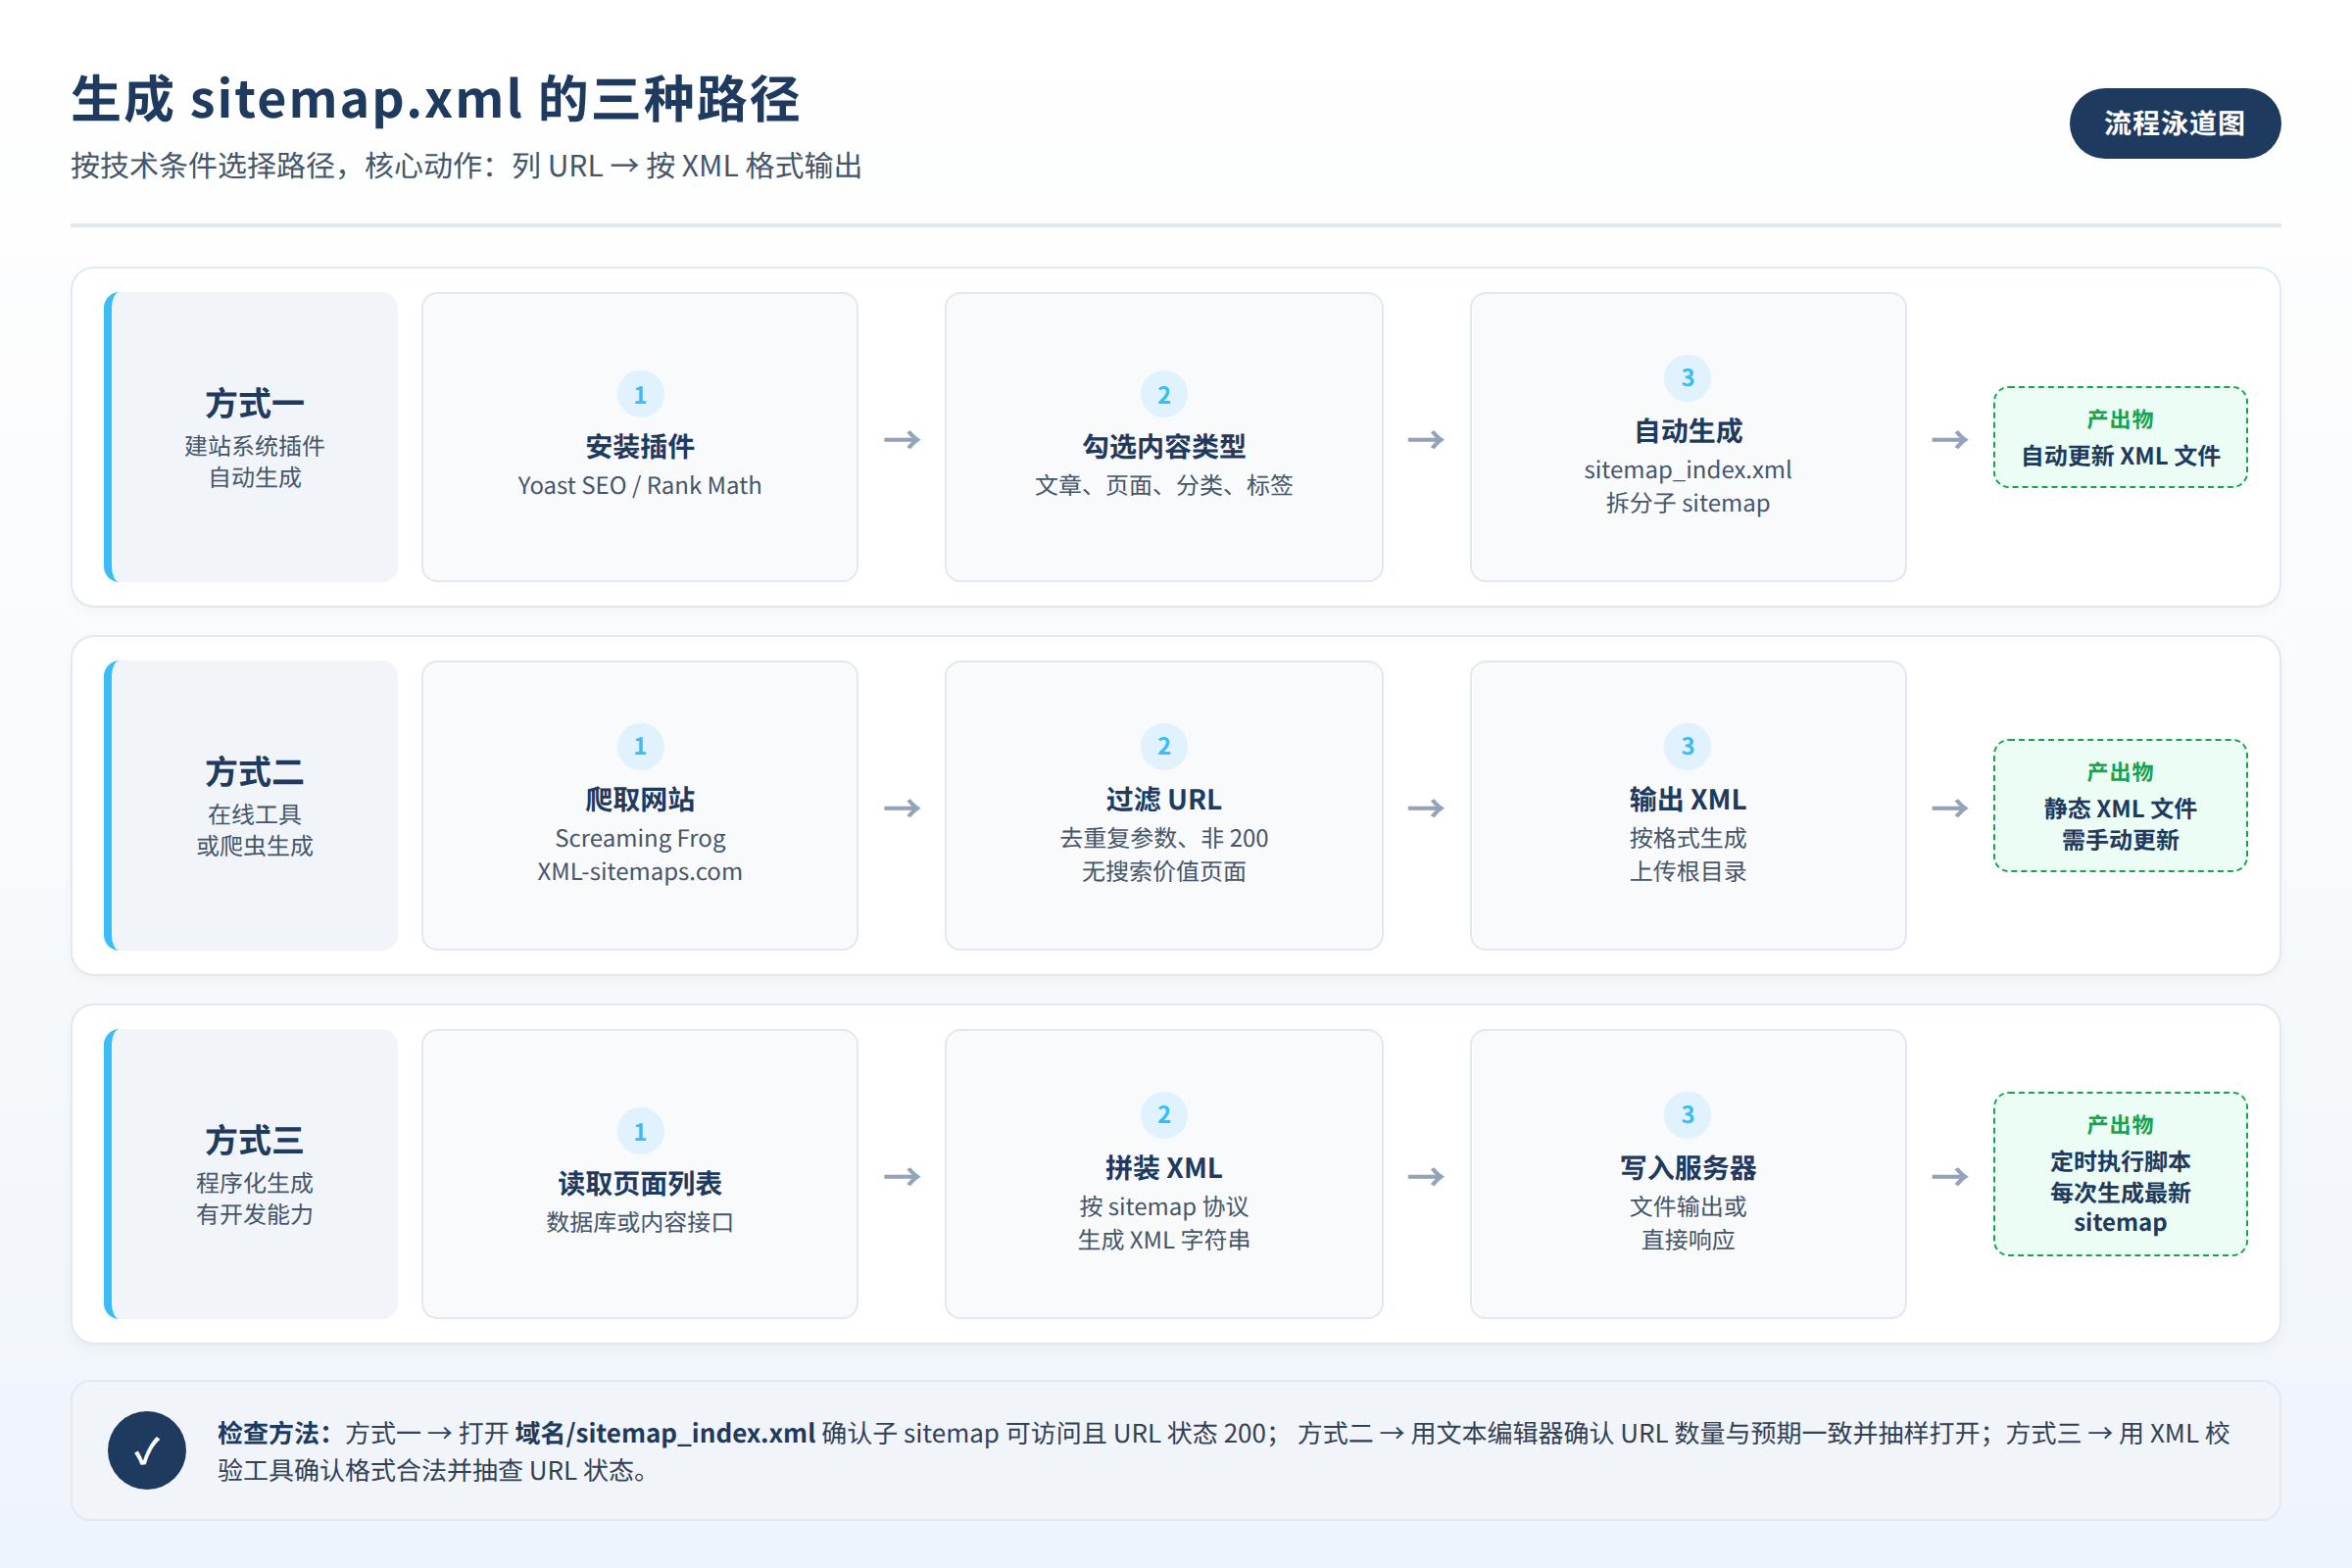
三种生成方式,按技术条件选
方式一:建站系统插件自动生成
适合用 WordPress、Shopify、Wix 等现成建站系统的人。
以 WordPress 为例,安装 Yoast SEO 或 Rank Math 后,插件会自动生成 /sitemap_index.xml,里面按文章、页面、分类、标签等类型拆分出多个子 sitemap。你只需要在插件设置里勾选哪些内容类型要进 sitemap,哪些要排除。
产出物:一个或多个自动更新的 XML 文件,新增内容后无需手动操作。
检查方法:打开 你的域名/sitemap_index.xml,确认每个子 sitemap 都能正常访问,且里面的 URL 都是 200 状态。
方式二:在线工具或爬虫生成
适合没有后台开发能力、网站页面数量在几百到几千之间的静态网站。
操作顺序:
- 用工具爬取自己的网站,常见的有 Screaming Frog、XML-sitemaps.com 等。
- 爬完后导出 URL 列表,过滤掉重复参数、非 200 状态码、无搜索价值页面。
- 按 XML 格式输出,上传到网站根目录。
产出物:一个静态 XML 文件,需要手动更新。
检查方法:用 Excel 或文本编辑器打开 XML 文件,确认 URL 数量与预期一致,再抽样打开部分 URL 确认状态码。
方式三:程序化生成
适合有开发能力、页面数量大、或者内容频繁变化的网站。
基本逻辑是:从数据库或内容接口读取需要收录的页面列表,按 sitemap 协议拼成 XML 字符串,写入服务器文件或直接输出响应。
一个最小可用的 Python 伪代码结构:
urls = get_all_publish_pages()  # 从数据库或接口取 URL 列表
xml_header = '<?xml version="1.0" encoding="UTF-8"?>'
xml_open = '<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">'
xml_body = ''
for url in urls:
    xml_body += f'<url><loc>{url}</loc></url>'
xml_close = '</urlset>'
sitemap = xml_header + xml_open + xml_body + xml_close
save_to_file('sitemap.xml', sitemap)
产出物:一个可定时执行的脚本,每次运行生成最新 sitemap。
检查方法:跑完脚本后,用 XML 校验工具确认格式合法,再抽查 URL 状态。
sitemap 文件本身要守的规矩
XML 格式错误是最常见的翻车点。几个硬性要求:
- 文件编码必须是 UTF-8。
- 每个 sitemap 文件最多 50,000 个 URL,未压缩文件大小不超过 50MB。超过就拆分成多个文件,再用 sitemap index 文件统一引用。
<loc>是唯一必填字段,<lastmod>、<changefreq>、<priority>都是可选字段。Google 官方明确表示会忽略<priority>和<changefreq>,百度也没有公开表示会参考这两个字段,所以不必花时间调这些值。- URL 中的特殊字符必须转义,比如
&写成&。
一个容易犯的错:把 <lastmod> 写成未来日期,或者每次生成时全部更新为当天。搜索引擎会认为这是欺骗信号,正确做法是只在内容真正更新时才改对应页面的 <lastmod>。
生成之后必须做的验证
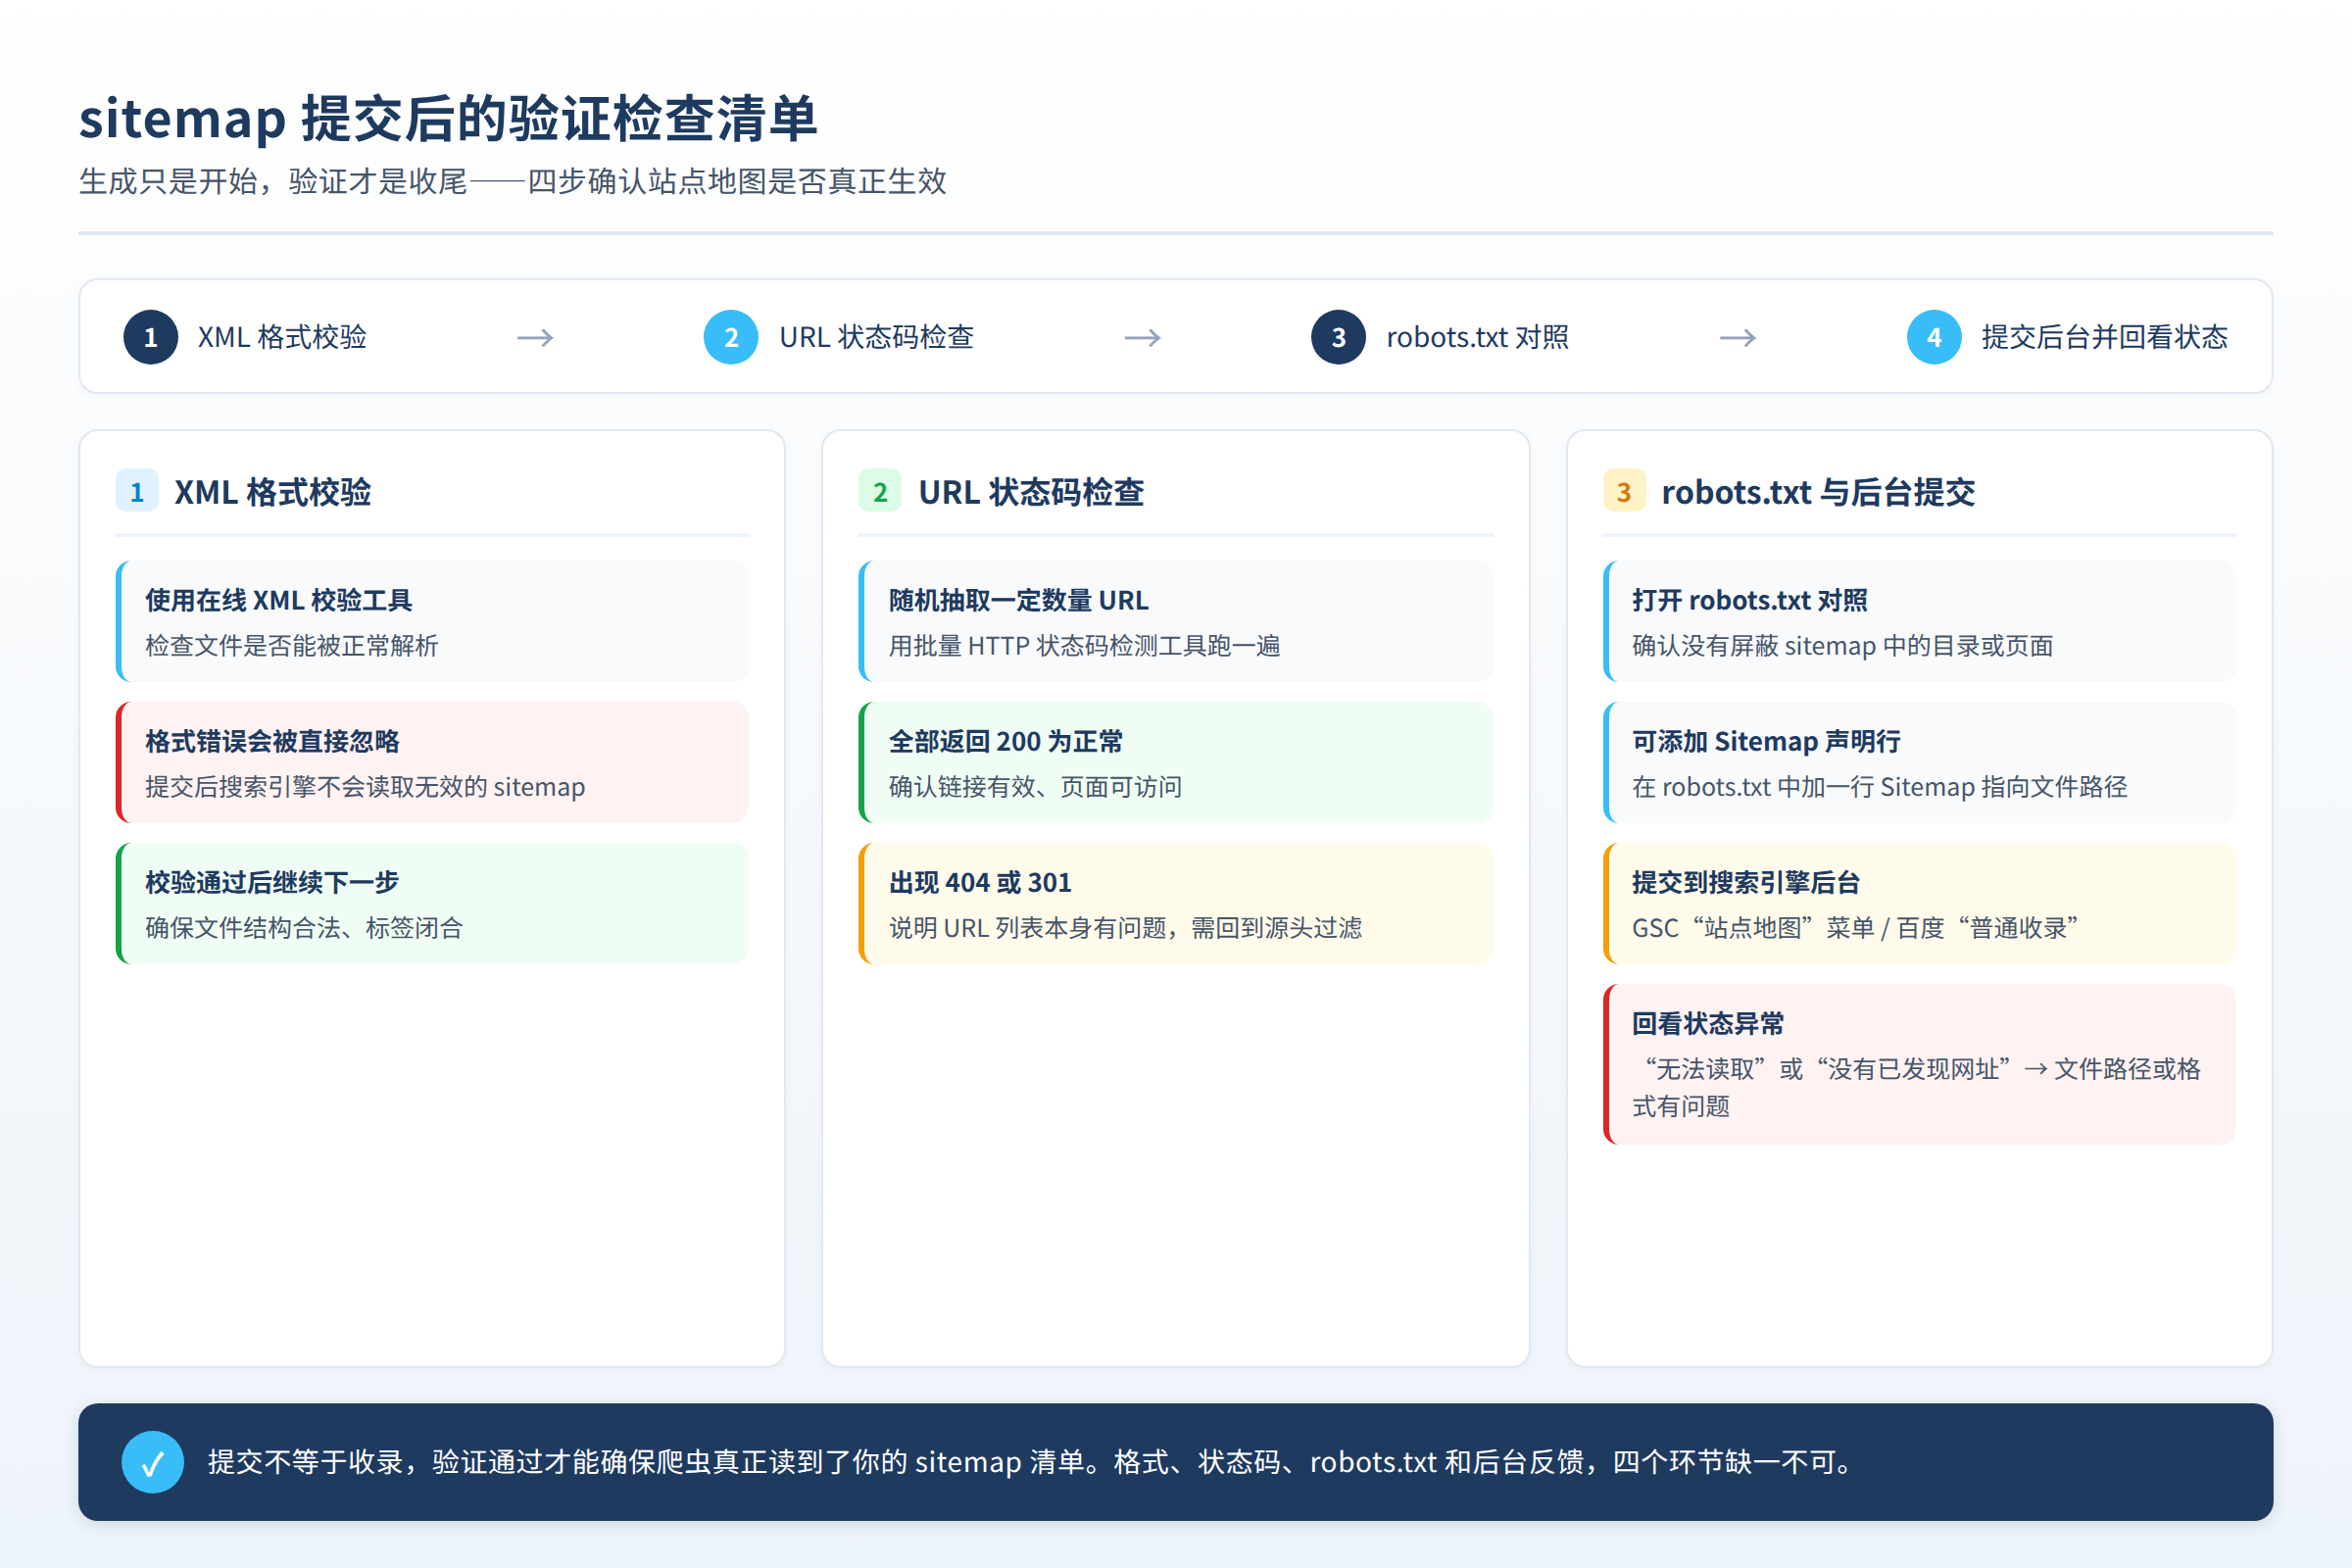
生成只是开始,验证才是收尾。
第一步:XML 格式校验。 用在线 XML 校验工具检查文件是否能被正常解析。格式错误的 sitemap 提交后会被直接忽略。
第二步:URL 状态码检查。 从 sitemap 里随机抽一定数量 URL,用批量 HTTP 状态码检测工具跑一遍,确认全部返回 200。如果出现 404 或 301,说明 URL 列表本身有问题,需要回到源头过滤。
第三步:与 robots.txt 对照。 打开 你的域名/robots.txt,确认里面没有屏蔽 sitemap 中出现的目录或页面。同时可以在 robots.txt 里加一行 Sitemap: https://www.example.com/sitemap.xml,给爬虫多一个发现入口。
第四步:提交到搜索引擎后台。 Google Search Console 的“站点地图”菜单里提交 sitemap URL,百度搜索资源平台的“普通收录”里做同样操作。提交后过一段时间回来看状态,如果显示“无法读取”或“没有已发现网址”,说明文件路径或格式有问题。
常见问题
问题:sitemap 提交后多久会被收录?
没有固定时间。提交只是告诉搜索引擎“这里有清单”,搜索引擎会按自己的节奏抓取。新站可能几天到几周,老站更新较快。提交后重点看后台的“已发现网址”数量是否与 sitemap 中的数量接近,而不是盯着收录时间。
问题:sitemap 里要不要放图片和视频?
如果图片搜索和视频搜索是你的流量来源,可以单独生成图片 sitemap 或视频 sitemap,使用对应的命名空间和标签。普通图文网站不需要把图片单独列进标准 sitemap。
问题:网站改版后 sitemap 怎么处理?
改版后先确认新 URL 结构,重新生成 sitemap,再在 Search Console 里删除旧 sitemap 并提交新的。旧 URL 如果已经做 301 跳转,搜索引擎会在后续抓取中逐步更新索引,sitemap 里只需要放新 URL。
sitemap 的价值不在生成动作本身,而在你整理 URL 清单时被迫想清楚:哪些页面值得被搜索到,哪些页面在浪费爬虫的抓取预算。想清楚这个问题,比纠结用哪个工具生成更有用。